


数据湖 vs 大数据:工业应用选型指南
“数据湖”与“大数据”是两个常被误解、混用的现代术语。因均暗示大量数据,有时被互换使用。实则二者不同,尽管定义尚未完全定型。
先回顾历史背景。2000 年代末,Facebook、Twitter 等社交媒体爆发式增长,数据科学家意识到其产生海量有价值个人数据的潜力。随之诞生处理分析大数据的新软件,典型如 Apache Hadoop——开源应用工具包,能处理大数据级信息。随后十年,物联网 (IoT) 登场,数百万新数据源涌现,洞察个人偏好模式的同时反馈产品自身信息。同时机器学习在工业界取得重要进展,推动工业领域(特别是自动化流程)处理海量数据的需求激增。所有预测显示全球数据总量将持续加速增长。参考:2016 年全球年互联网流量突破 1 ZB(1 万亿 GB);2021 年预计超 3 ZB。这些预测加上云计算能力扩展,表明大数据与数据湖的价值与用途或许才刚刚开始。
什么是大数据?
单从体量看,大数据定义是个移动目标。随着数据量与存储空间增长,“大量信息”的基准也在水涨船高。如今 100 TB 以上数据仓库普遍视为大数据范畴;社交平台数据仓库可达数 PB 级。另一参照标准:信息量超出传统工具(如 SQL)处理能力。例如现在数据库年增 1 TB 并不罕见,但 SQL 功能增强后仍可管理,故通常不算大数据。
大数据的 4V 模型
除体量 (Volume),还有三大关键因素:速度、多样性、真实性。四者构成 4V 模型。
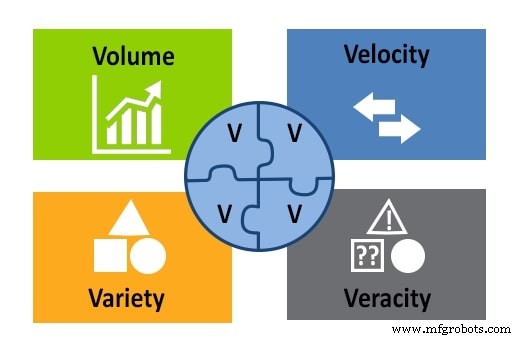
多样性指大数据仓库存储的各类数据:文本、图像、音频、视频等,也指多数据源。速度关注数据采集、生成、分发的快慢——大数据持续流入。真实性衡量数据准确性与质量,评估数据科学家能否用于分析并得出结论。理解大数据后,再看数据湖,再探讨如何在控制系统中应用。
什么是数据湖?
数据湖是大量原始数据的中心化存储库——这些信息未来可能有价值也可能没有,用途尚未完全明确。数据湖可存储关系型与非关系型数据库,以及其他类型文件与实体。虽未处理组织,但输入输出均经结构化设计以保证良好架构。
数据湖 vs 大数据
数据湖是大数据应用的一个实例。符合 4V 模型标准,有自身特性:体量上,数据湖平均处于大数据下限;多样性上,仅限未处理原始数据;输入输出速度同等重要;设计良好的数据湖会执行数据质量评估。
数据的工业应用
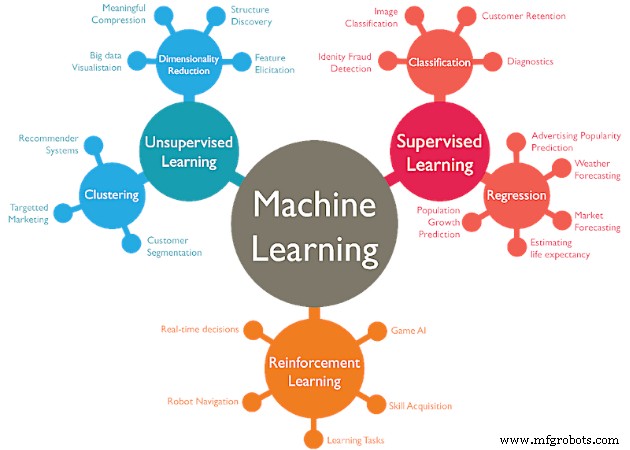
先进自动化推动工厂车间处理信息量激增。制造等工业流程正步入大数据领域,多项业务活动已采用数据湖等工具。典型例:预测性维护。预测机电故障极具价值,可大幅节省维修成本。数据湖可汇编日志文件、多传感器、输入设备数据,洞察趋势、预测问题。机器学习让机器人适应外部环境变化,采集信息类似预测性维护,额外将评估与流程变更自动反馈给系统控制器。机器学习数据可存储于结构化数据湖。
综上,数据湖是大数据应用的一个实例。二者可协同工作。控制工程师利用大数据与数据湖,可预测故障、制定维护计划、推进工厂数字化转型等。你在工作中如何运用大数据与数据湖?
物联网技术