


攻克物联网数据 ETL 挑战,提升 ROI
通过发展 ETL 技术专长快速、高性价比挖掘物联网数据商业价值
物联网潜力从未如此巨大。预计 2021 年物联网设备投资翻倍,数据和分析板块机会激增,主任务是克服挑战、驯服物联网数据项目成本。
组织可通过发展 ETL(抽取、转换、加载)技术专长(如流处理和数据湖)优化物联网数据,快速、高性价比推导其商业价值。
延伸阅读: 4 Principles to Enabling a Pristine Data Lake
但许多组织这可能导致 IT 瓶颈、项目长期延迟、数据科学被推迟。结果:预测分析数据本应在提高运营效率和激发创新中起关键作用的物联网项目——仍未跨过概念验证门槛,绝对无法展示 ROI。
理解物联网面临的 ETL 挑战
下图帮助更好理解问题:
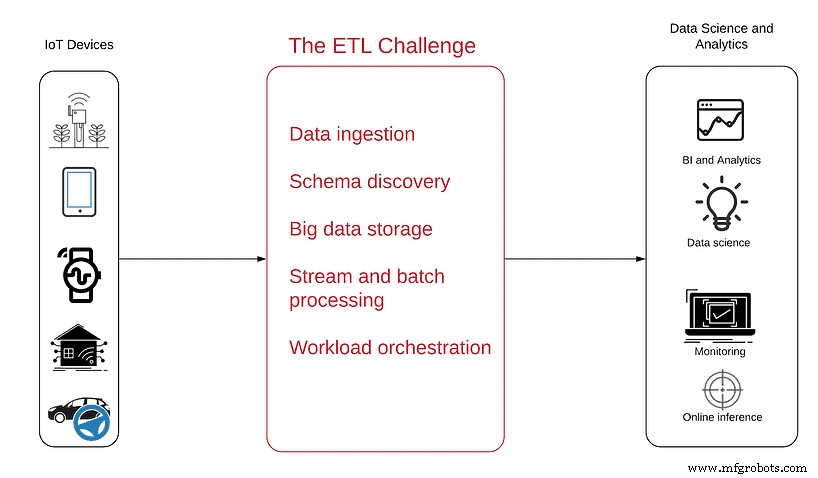
左侧是数据源——无数填满传感器设备,从简单天线到复杂自动驾驶汽车,生成物联网数据并作为半结构化数据不间断流通过网络发送。
右侧是消费所述数据应达成目标,项目结束时产生的分析产品,包括:
- 商业智能 以获取产品使用趋势和模式可见性
- 运营监控 以实时查看中断和非活跃设备
- 异常检测 以获取数据峰值或骤降主动警报
- 嵌入式分析 使客户能查看理解自身使用数据
- 数据科学 享受高级分析和机器学习在预测性维护、路线优化或 AI 开发中效益
为达成这些目标,需先将数据从原始流模式转换为可用 SQL 和其他分析工具查询的分析就绪表。
ETL 过程常是任何分析项目最难理解片段,因为物联网数据包含一组独特品质,不总与常规关系数据库、ETL 和 BI 工具同步。例如:
- 物联网数据是流数据, 在小文件中持续生成,累积成海量蔓延数据集。这些与传统表格数据截然不同,需更复杂 ETL 执行连接、聚合、数据丰富化。
- 物联网数据必须先存后分析。 与典型数据集不同,物联网设备创建数据巨大量意味着必须有地方放置才能分析——云或本地数据湖。
- 物联网数据因多设备呈现无序事件 可能进出互联网连接区域。意味着日志可能不同时到达服务器、不总按“正确”顺序。
- 物联网数据常需低延迟访问。 运营上,可能需实时或近实时识别异常或特定设备,不能承受批处理导致延迟。
是否应用开源框架创建数据湖?
为构建企业数据分析平台,许多组织用此常见方法:用开源流处理框架作构建块加时序数据库如 Apache Spark/Hadoop、Apache Flink、InfluxDB 等创建数据湖。
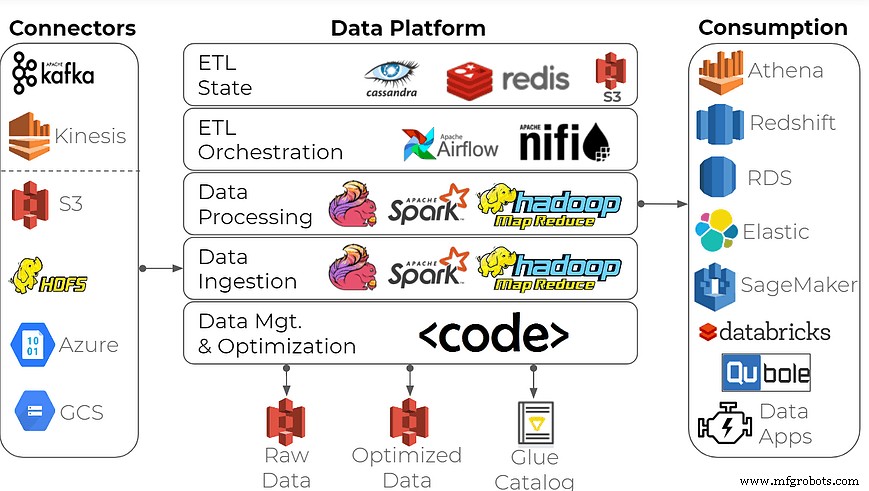
这工具组能干活?能,但做对除最资深数据经验公司外令所有公司不堪重负。构建此类数据平台需大数据工程师专业技能和对数据基础设施强关注——非通常制造和消费电子等紧贴物联网数据行业强项。预期延期交付、高昂成本、大量浪费工程工时。
若组织想要高性能加全功能和用例——运营报告、即席分析、机器学习数据准备——则采用合适解决方案。例如使用专为将流转换为分析就绪数据集的数据湖 ETL 平台。
解决方案不像 Spark/Hadoop 数据平台那样僵化复杂。用自助用户界面和 SQL 构建,非 Java/Scala 密集编码。对分析师、数据科学家、产品经理、DevOps 和数据工程中的数据提供者,可成真正用户友好工具:
- 为数据消费者提供自助服务,无需依赖 IT 和数据工程
- 优化 ETL 流和大数据存储降低基础设施成本
- 因全托管服务,让组织专注功能而非基础设施
- 移除维护多系统为实时数据、即席分析和报告需求
- 确保数据从不离开客户 AWS 账户以实现完全安全
你可从物联网数据受益——只需正确工具使其有用。
物联网技术