


模拟存内计算:能效边缘AI推理新范式
机器学习与深度学习已融入日常技术。从自然语言助手到实时目标检测,AI驱动日益增长的消费与工业设备。然而多数应用依赖云端推理引擎——此架构引发隐私、功耗、延迟与成本担忧。
在边缘本地部署AI可消除这些问题。主要障碍是传统数字神经网络加速器的内存驱动功耗。当权重与激活从DRAM或SRAM取出,数据移动本身消耗能量比算术运算高两到三个数量级。模拟存内计算通过在非易失性存储阵列内直接执行乘累加(MAC)运算攻克此瓶颈。
云端AI:痛点
边缘设备将原始数据转发远程服务器时,多问题浮现:
- 隐私与安全——个人或机密信息在数据中心传输存储。
- 不必要的能耗——每比特经无线电发送、云端存储、重新检索均消耗能量。
- 小批量推理延迟——响应超100ms,用户可感知。
- 数据经济低效——传感器生成海量流;上传一切既不经济不可持续。
为克服挑战,先在高性能平台(云、GPU农场等)训练模型。所得权重映射至轻量推理引擎在本地计算。
神经网络的MAC密集本质
即使轻量模型亦以MAC为主。例MobileNet-v1配224×224输入含420万参数,单次推理需5.69亿MAC。乘法与累加在稠密矩阵-向量乘积中执行。
数字计算为何挣扎
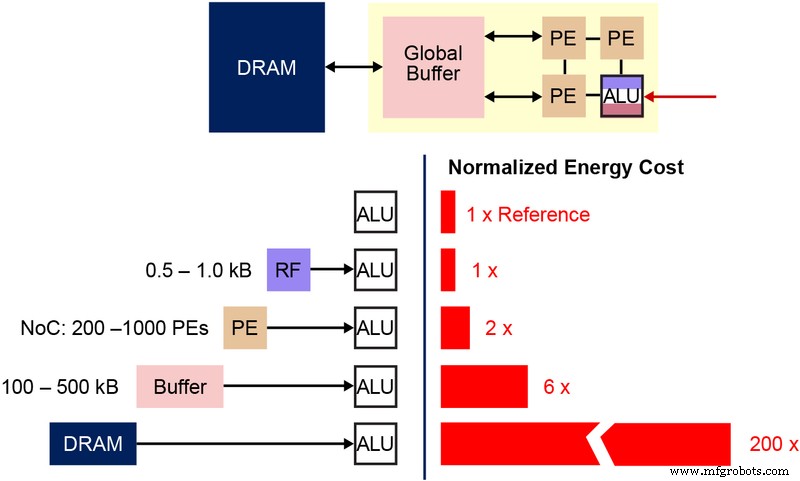
传统加速器中,权重与激活存DRAM/SRAM,须取入算术逻辑单元(ALU)。图3展示内存瓶颈:移动数据能量(50-100pJ/次)远超每MAC 250fJ。即使激进数据复用,冯·诺依曼架构仍给能效设硬上限。
模拟存内计算破局
将计算嵌入存储阵列本身,消除权重搬运需求。剩余数据传输仅限输入信号——典型为传感器输出。亚阈值工作的Flash单元耗亚纳安电流,主动功耗可忽略。待机时非易失性单元零功耗保持数据。
Silicon Storage Technology(Microchip旗下)的memBrain™平台体现此路径。基于SuperFlash®(ESF3)存储技术,每个位单元可编程为精确阈值电压(Vt),建立代表权重的电导。施加输入电压时,单元电流等于输入与存储权重乘积。
多电平存储架构
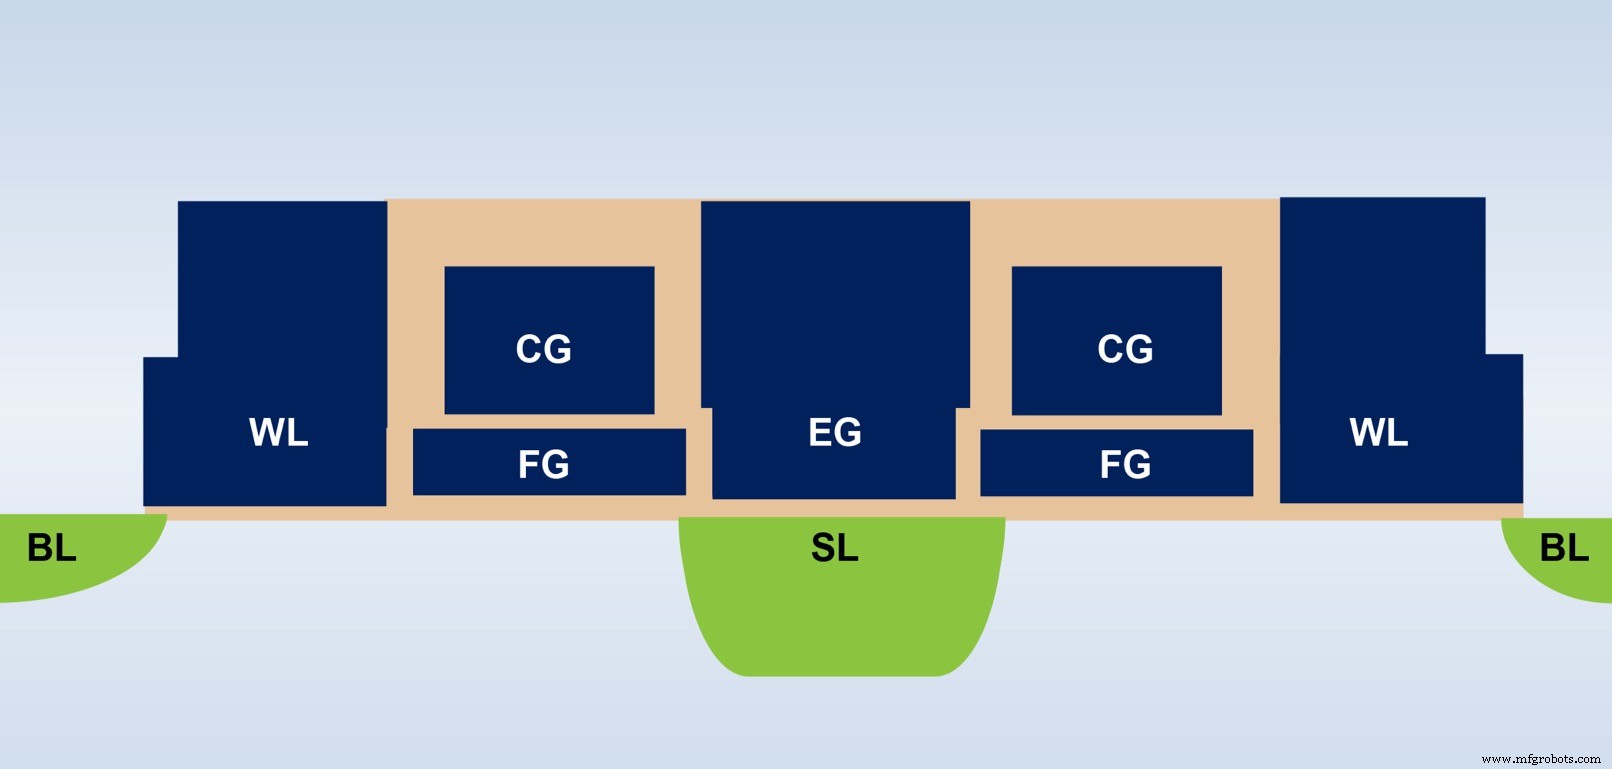
图4展示ESF3位单元剖面。单元含五端——控制栅(CG)、字线(WL)、擦除栅(EG)、源极线(SL)、位线(BL)。高压EG编程浮栅,其他端低压偏置读写单元。
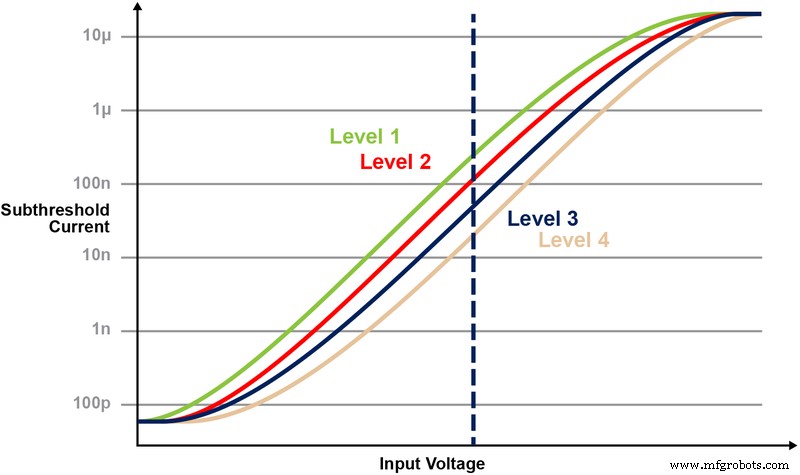
精细编程调节浮栅Vt产生特定I-V曲线。图5演示2-bit例:四个离散Vt电平在固定CG电压下产生四个分离电流响应。
存储阵列中的MAC
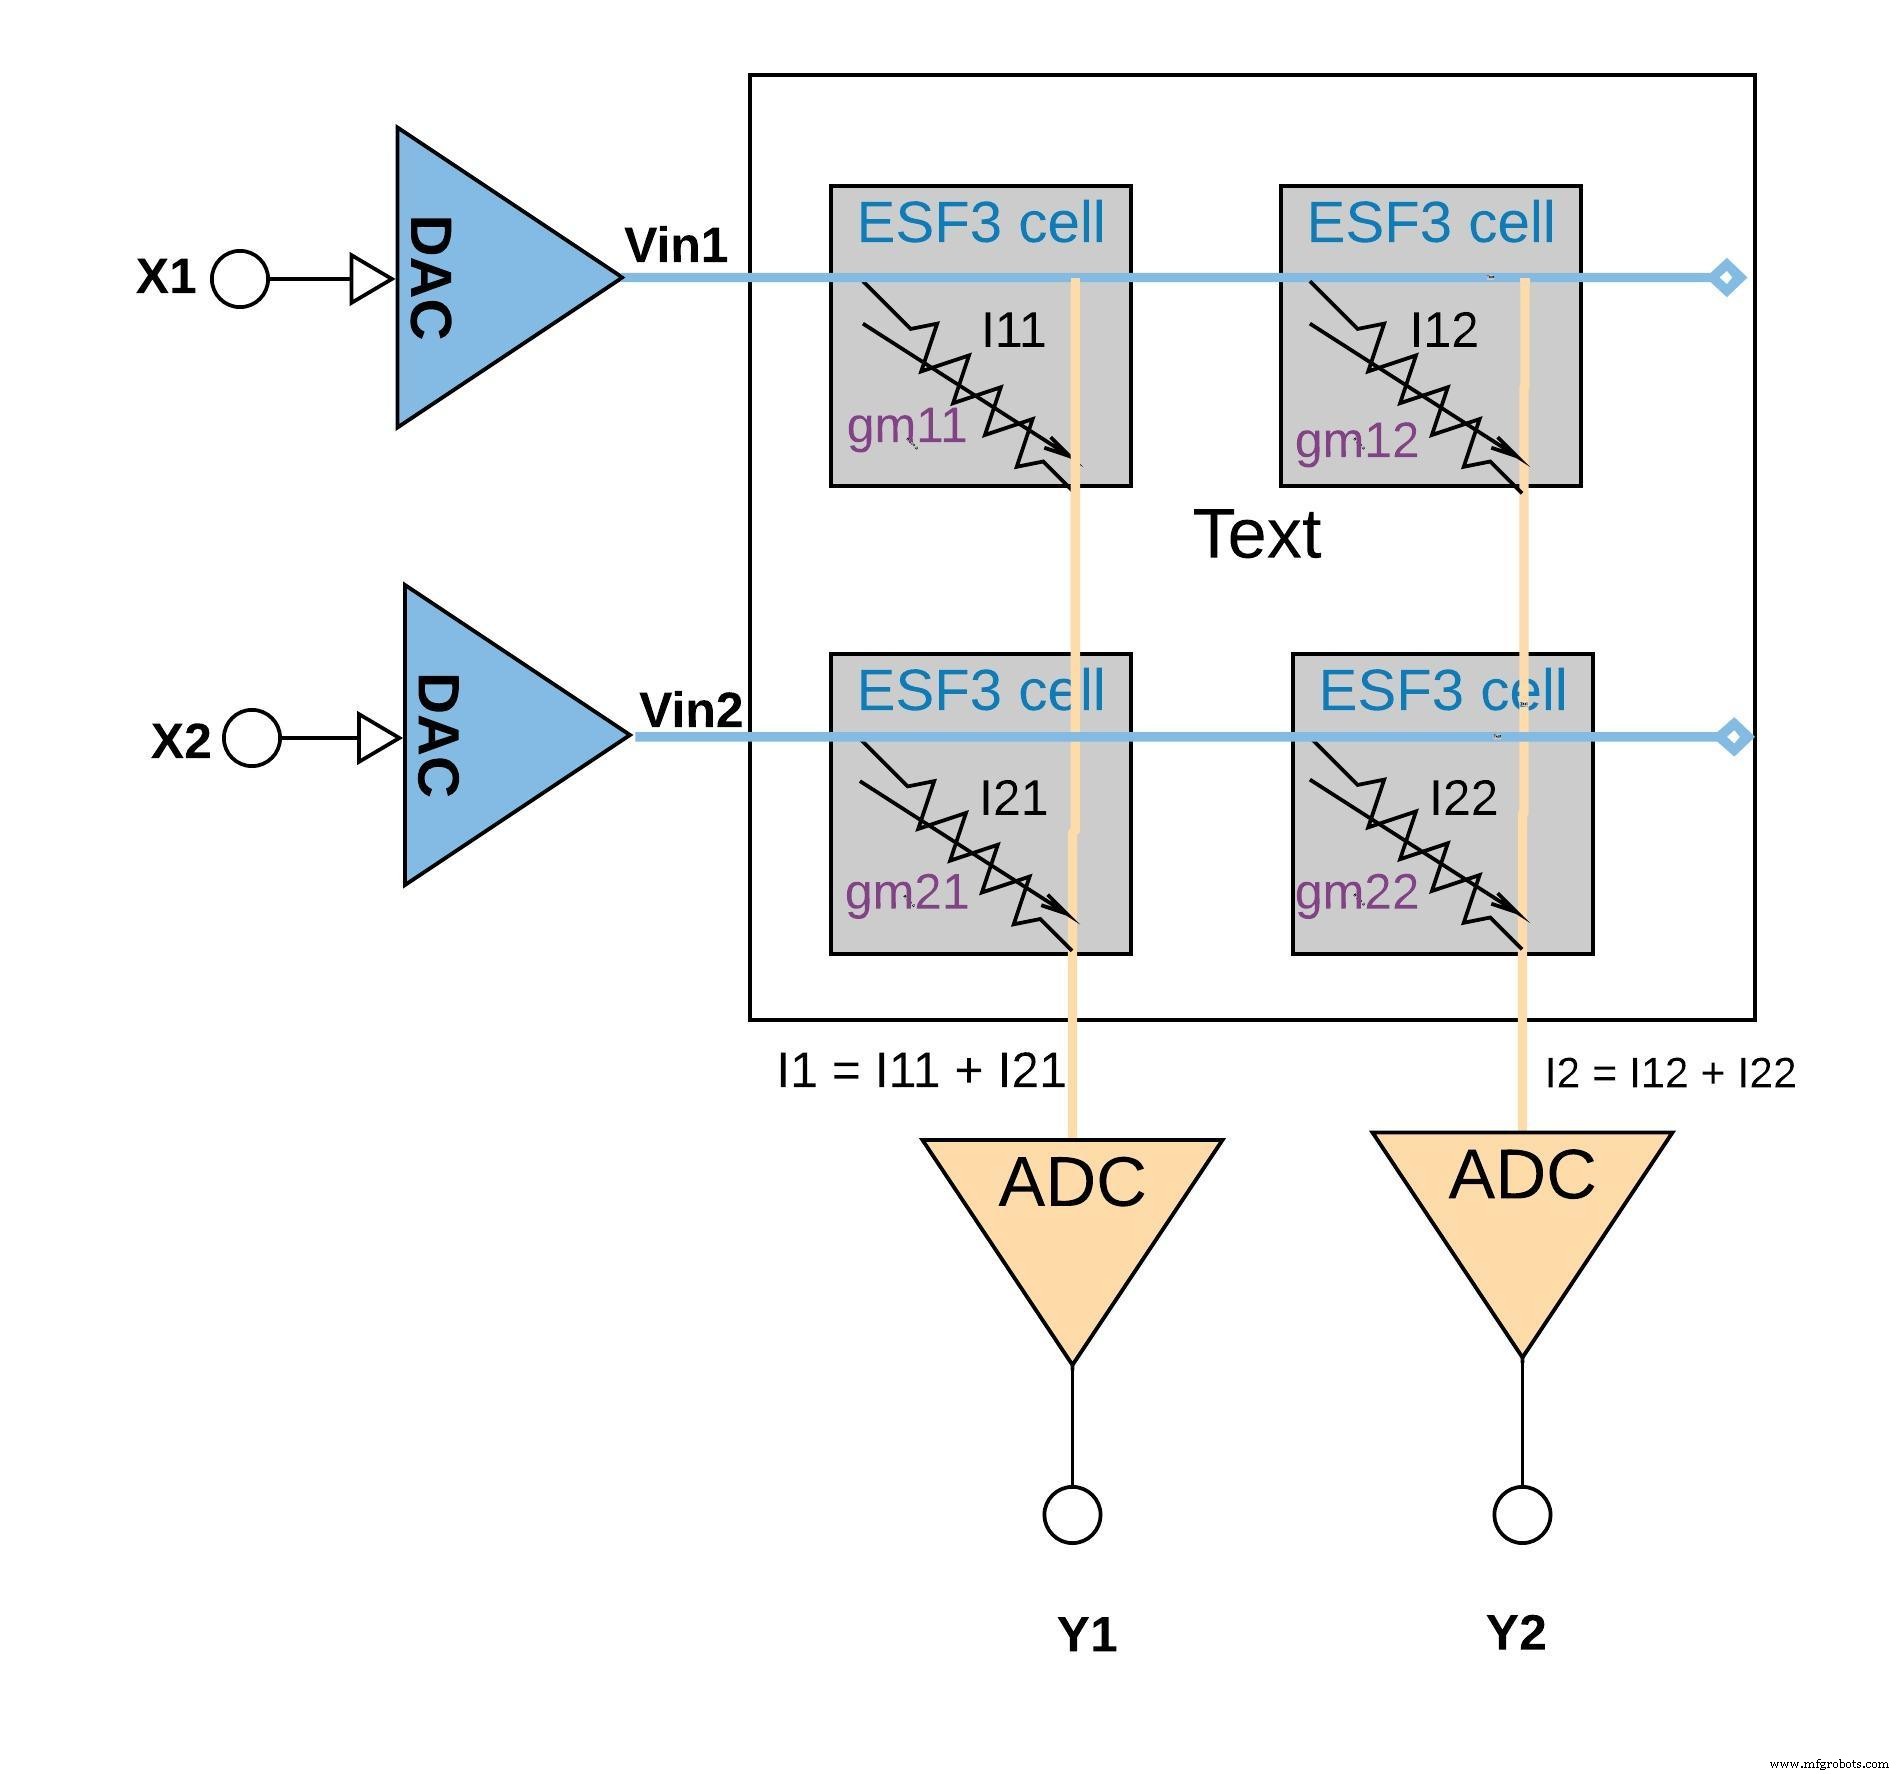
每个单元电导gm体现训练权重。电流Iout = gm · Vin实现乘法步骤。并联多单元,列电流自然求和,得累加操作。图6可视化2×2阵列执行两次MAC与一次累加。
更大规模下,权重矩阵可映射至单一存储阵列。图7展示全连接层矩阵内存布局。
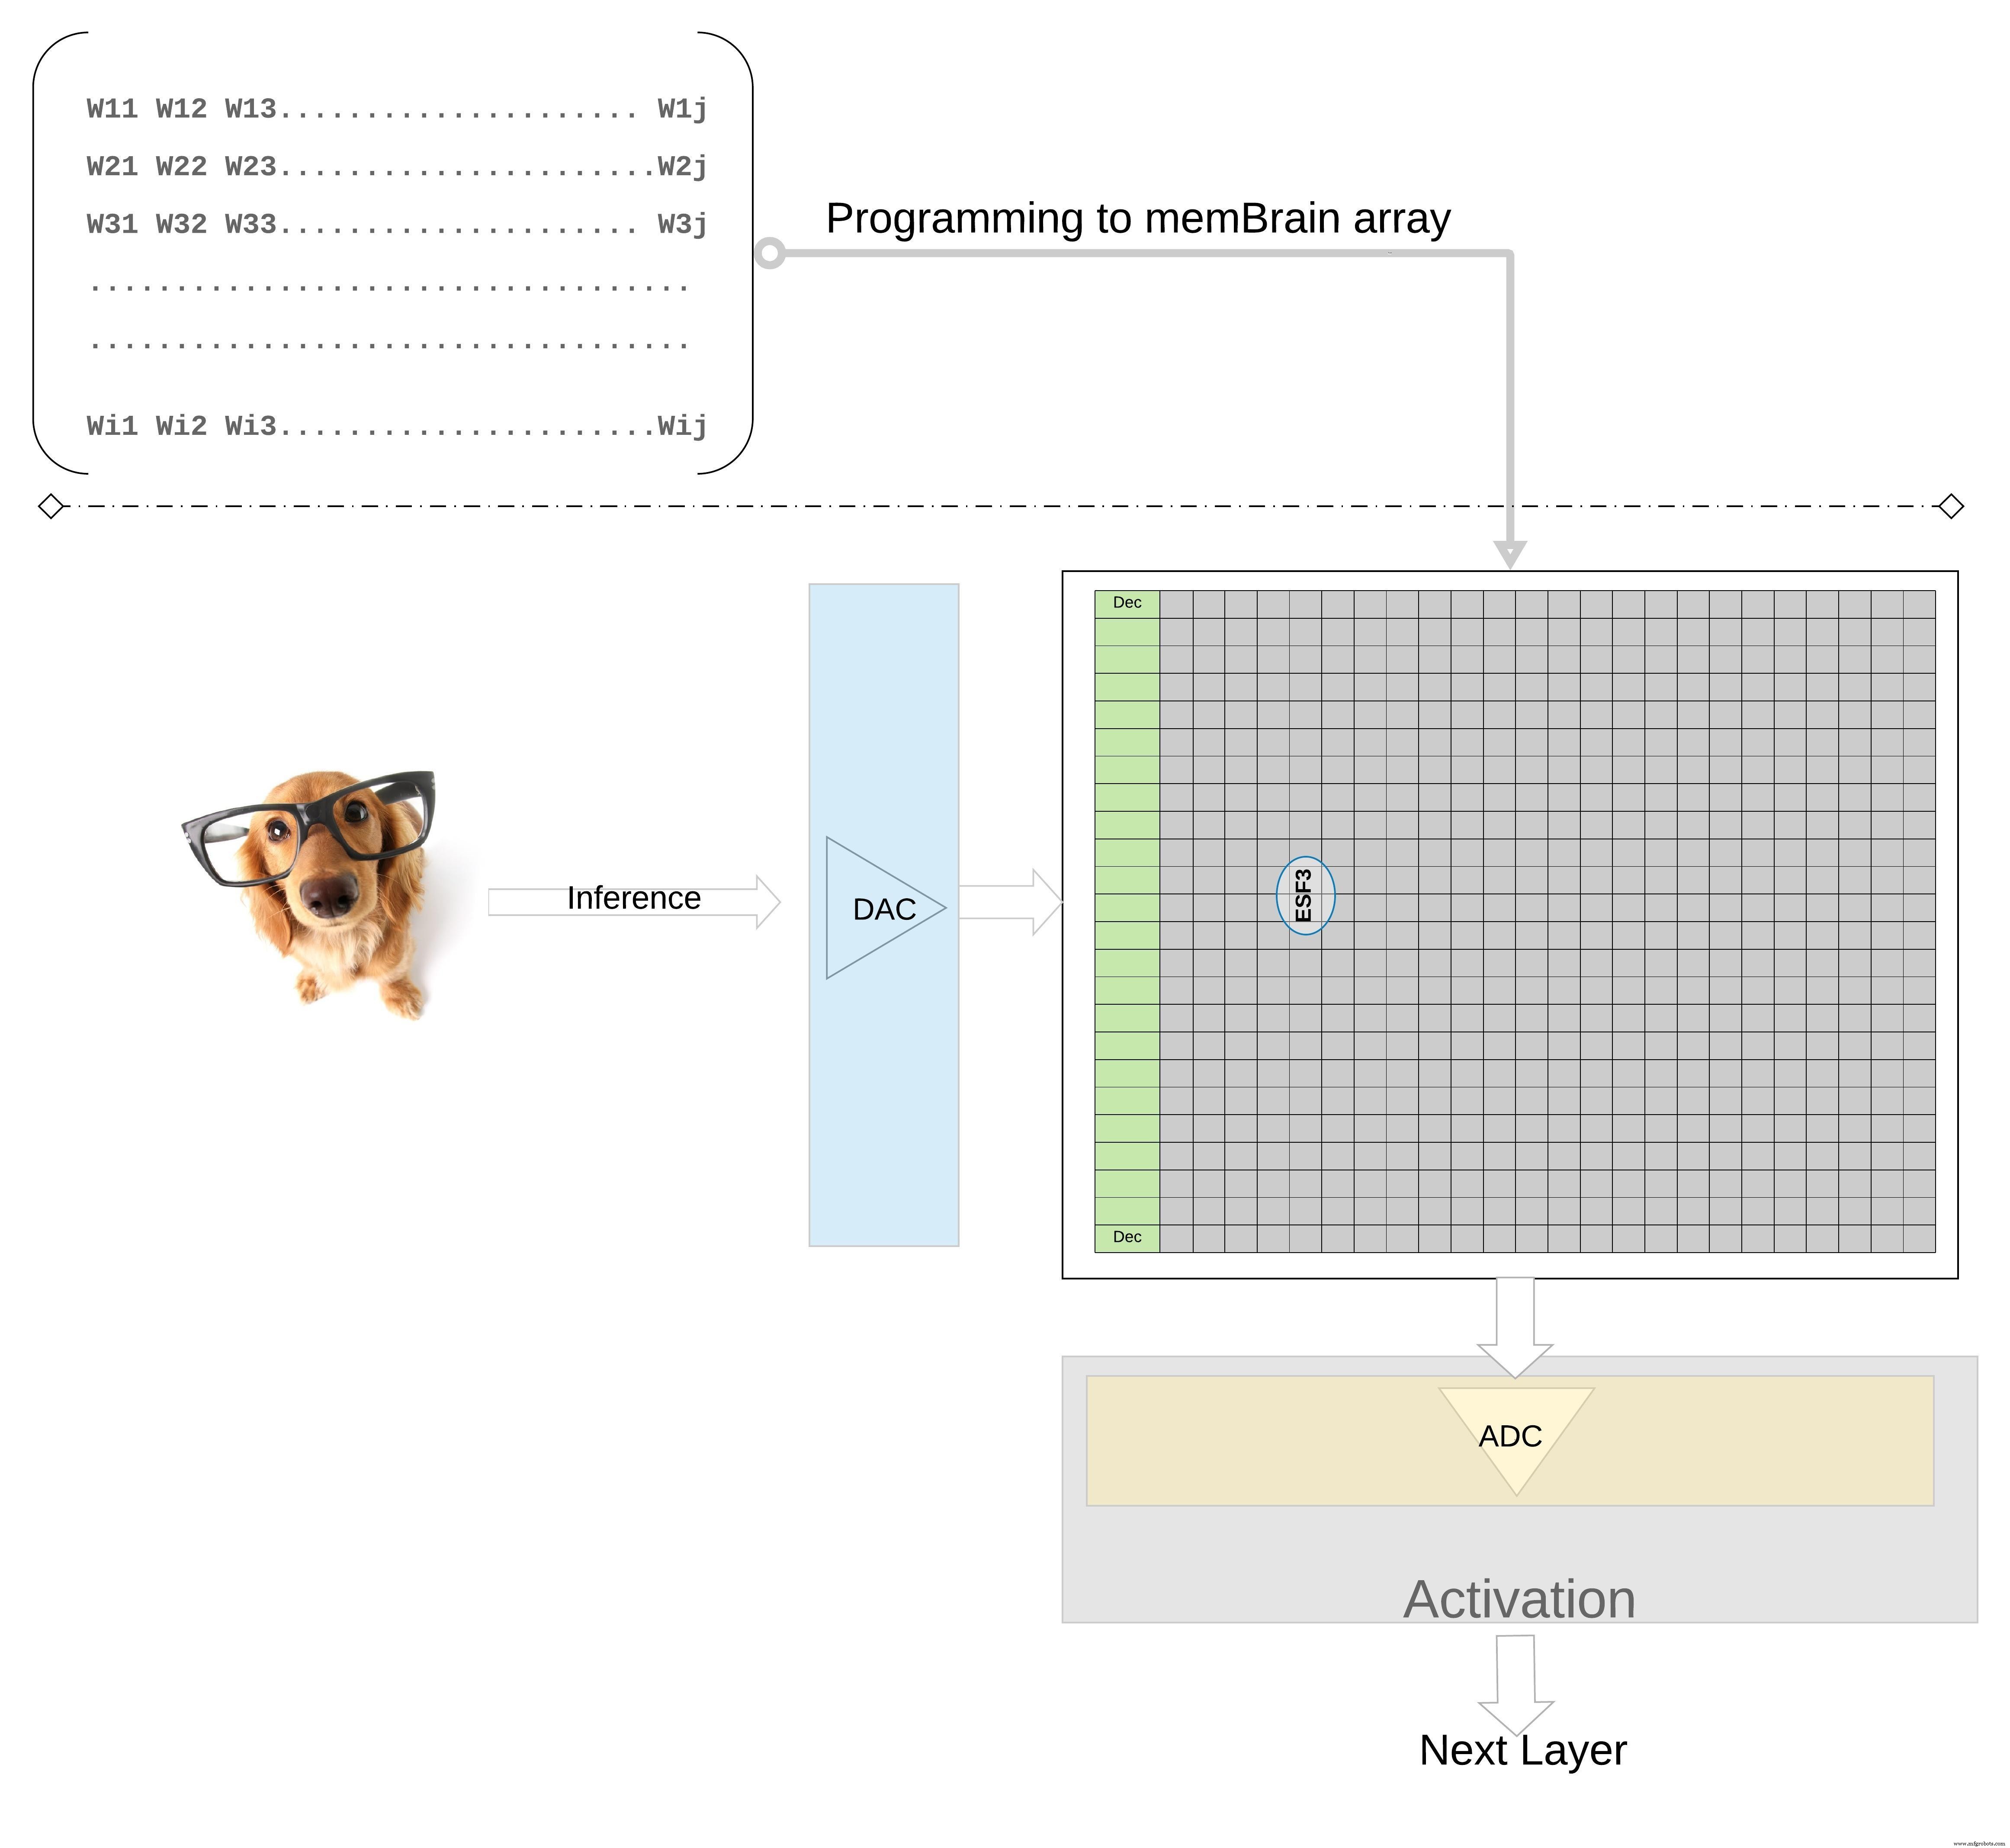
推理流程直观:传感器数据数字化、DAC转模拟电压、馈入阵列、列电流经ADC数字化供后续激活与池化阶段。
模块化与扩展性
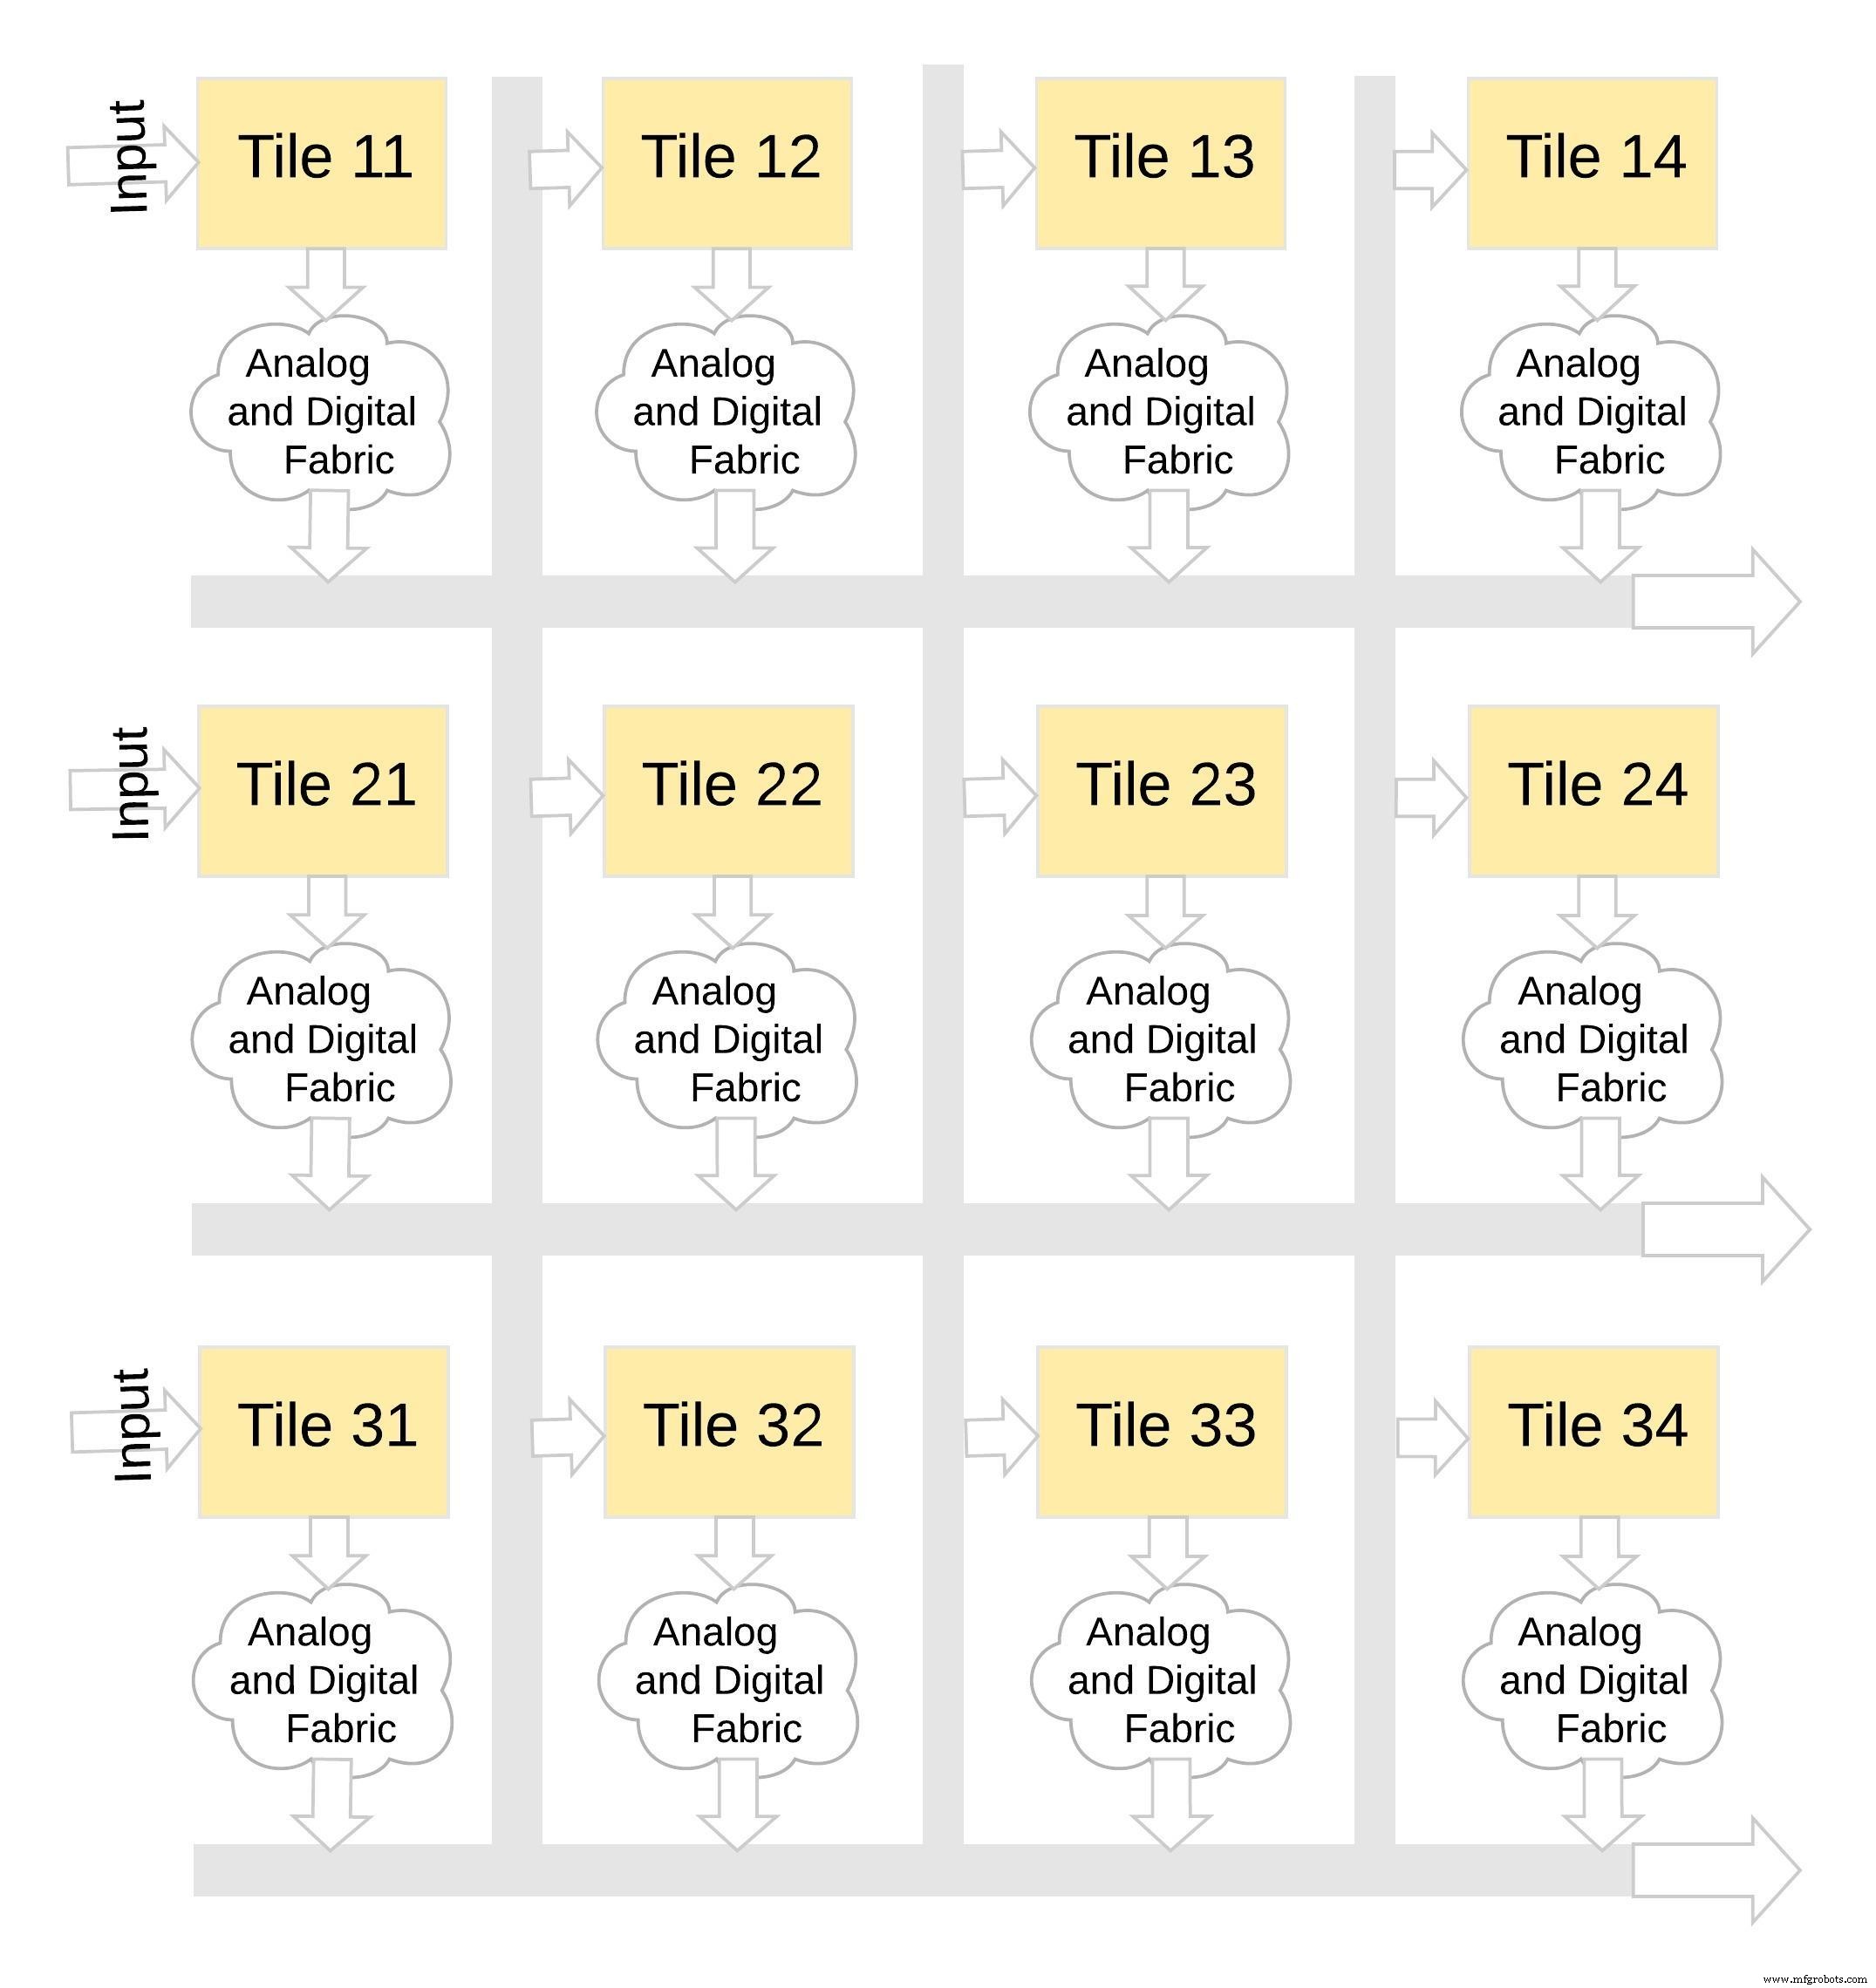
memBrain瓦片设计为可堆叠。图8展示3×4配置,多瓦片共享公共模数互连。数据经共享总线跨瓦片移动,支持构建深层网络而无需单一巨型芯片。
软件开发包(SDK)
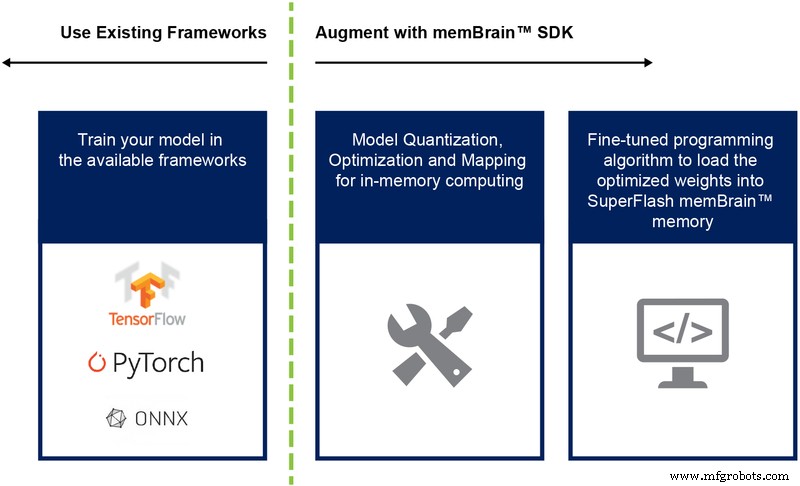
配套SDK框架无关。无论TensorFlow、PyTorch或其他库训练,SDK处理模型量化、映射、部署至memBrain硬件。图9勾勒训练到推理工作流。
核心优势
- 超低功耗——存内计算消除数据移动,Flash单元亚阈值工作,零待机功耗。架构亦利用稀疏性,零权重或输入使单元闲置。
- 紧凑占板——1.5晶体管分栅单元存4-bit值,而6晶体管SRAM同数据需24晶体管。芯片面积大幅缩减。
- 降低开发成本——利用成熟Flash工艺、避免超密集几何,掩膜套件成本与周期显著低于面向边缘AI的ASIC。
边缘AI预示变革性应用,但功耗与成本仍为限制因素。模拟存内计算,凭借验证済多电平Flash技术,提供将智能推理带至传感器端的务实、低成本路径。
嵌入式