


在微控制器上部署AIoT:实用指南
在近期文章中,我探讨了人工智能如何日益融入物联网设备,催生出能从数据学习并自主决策的智能AIoT解决方案。这些系统与周围环境展现类人交互,提升产品功能和用户体验。
AI与物联网的结合为微控制器(MCU)开辟了新市场。通过将简单MCU与AI加速相结合,开发者可将智能嵌入曾仅依赖基础传感器的设备。现代AI赋能MCU融合用于计算的数字信号处理(DSP)与机器学习(ML)推理,支持关键词识别、传感器融合、振动分析和语音识别等应用。高性能MCU现已支持视觉和成像任务——人脸识别、指纹分析、自主机器人——将曾专属于MPU和GPU的能力带到边缘。
边缘设备中的AI技术
机器学习(ML):ML算法从代表性数据构建模型,使设备能自动检测模式。厂商提供算法、API和训练工具,让嵌入式系统运行预训练模型进行推理。常见用例包括传感器中枢、关键词识别、预测性维护和分类。
深度学习:ML的子集,通过训练多层神经网络从复杂输入中提取高级特征。深度学习擅长处理大规模多样化数据集,随迭代持续改进。应用涵盖图像处理、聊天机器人和人脸识别。
自然语言处理(NLP):NLP使系统能理解并响应人类语言——文本或语音,基于输入做决策。它驱动语音识别、机器翻译和预测输入。
计算机视觉:该领域训练机器捕获、解读并响应图像数据。借助深度学习,系统可实时识别和分类物体。用例包括制造缺陷检测、医疗诊断、零售人脸识别和自动驾驶测试。
MCU上的AIoT
历史上,AI驻留在拥有大内存和强大核心的MPU和GPU中,以处理繁重工作负载。向边缘智能的转变现将AI置于MCU上,驱动力在于降低延迟、减少带宽和收紧功耗预算。近期MCU具备足够算力和内存,可承载针对受限设备定制的轻量级神经网络(NN)框架,使边缘实时推理成为可能。
神经网络由处理加权输入以产生输出的节点层组成。训练阶段(通常在云端)数据流经网络,反向传播调整权重以最小化预测误差。训练完成后,固定权重存储在闪存中,使MCU能以极少RAM执行推理。
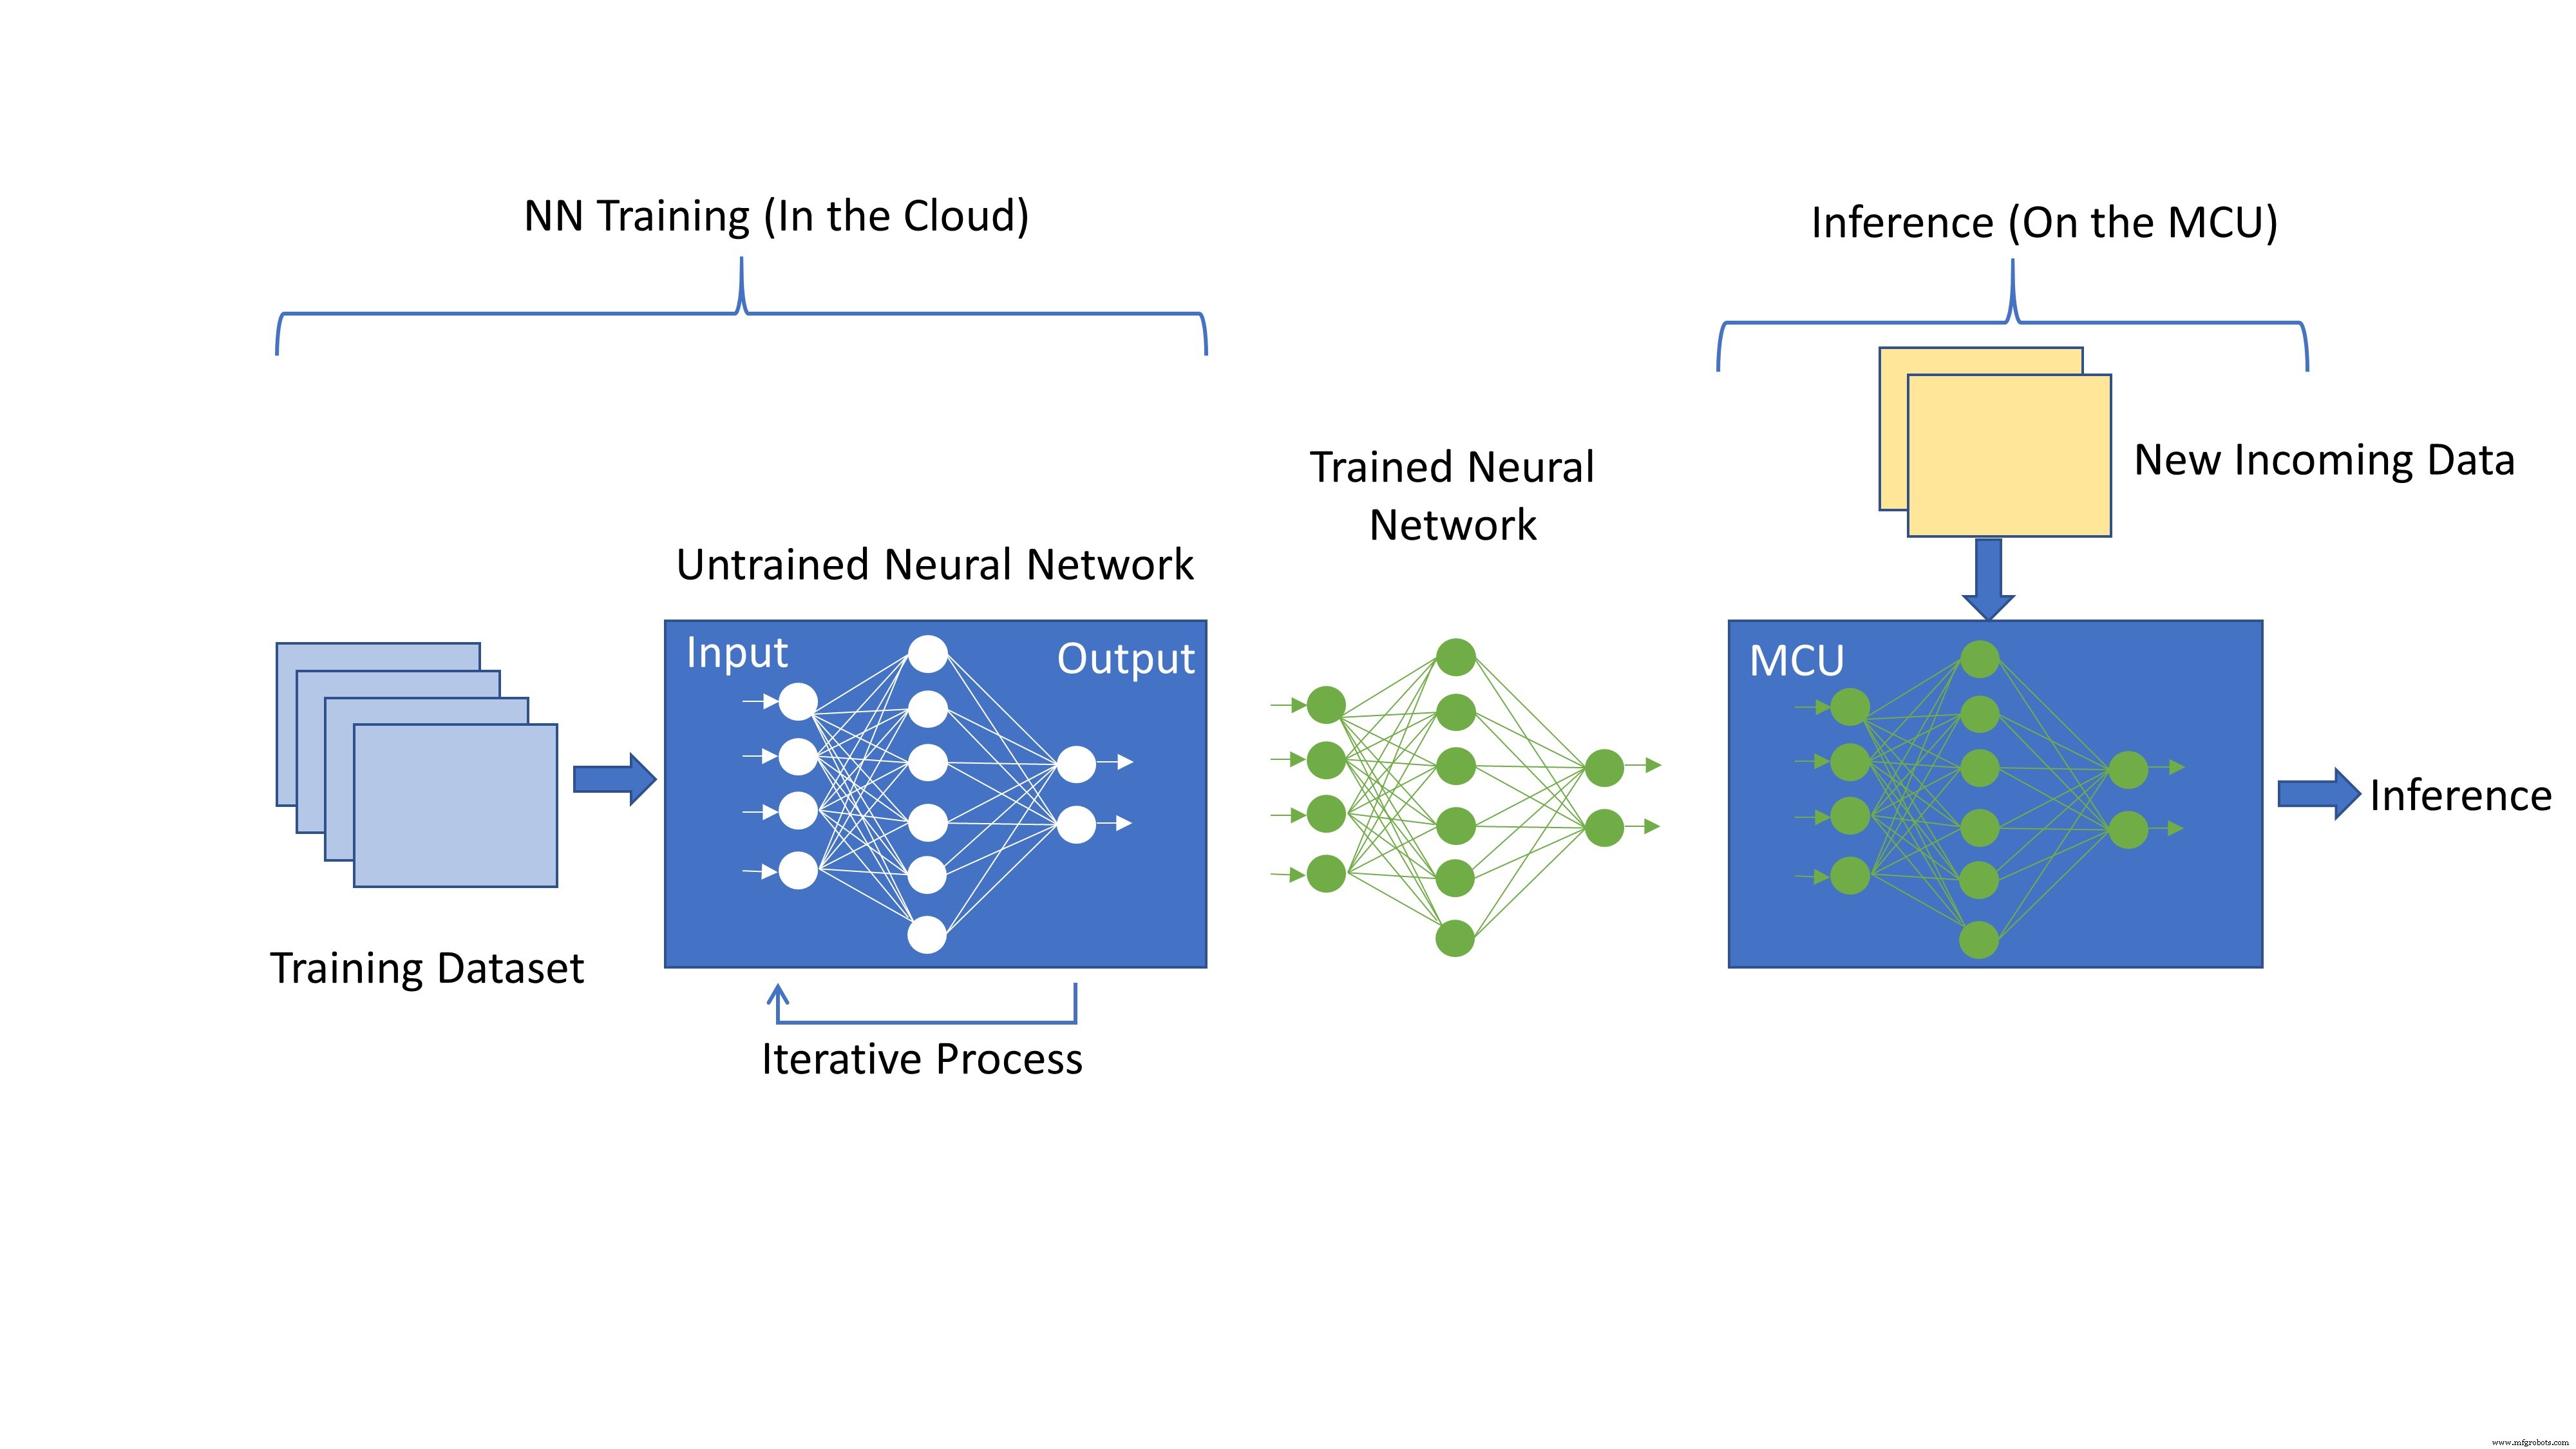
推理所需计算远少于训练,使MCU成为预训练模型的理想宿主。权重保持静态,MCU可基于新传感器数据即时决策。
在MCU上实现AI
典型工作流包含四阶段:
- 数据采集:从目标设备或应用收集大量数据集。
- 模型训练:使用AI厂商的云端工具(如TensorFlow Lite、Caffe)训练满足应用需求的神经网络。
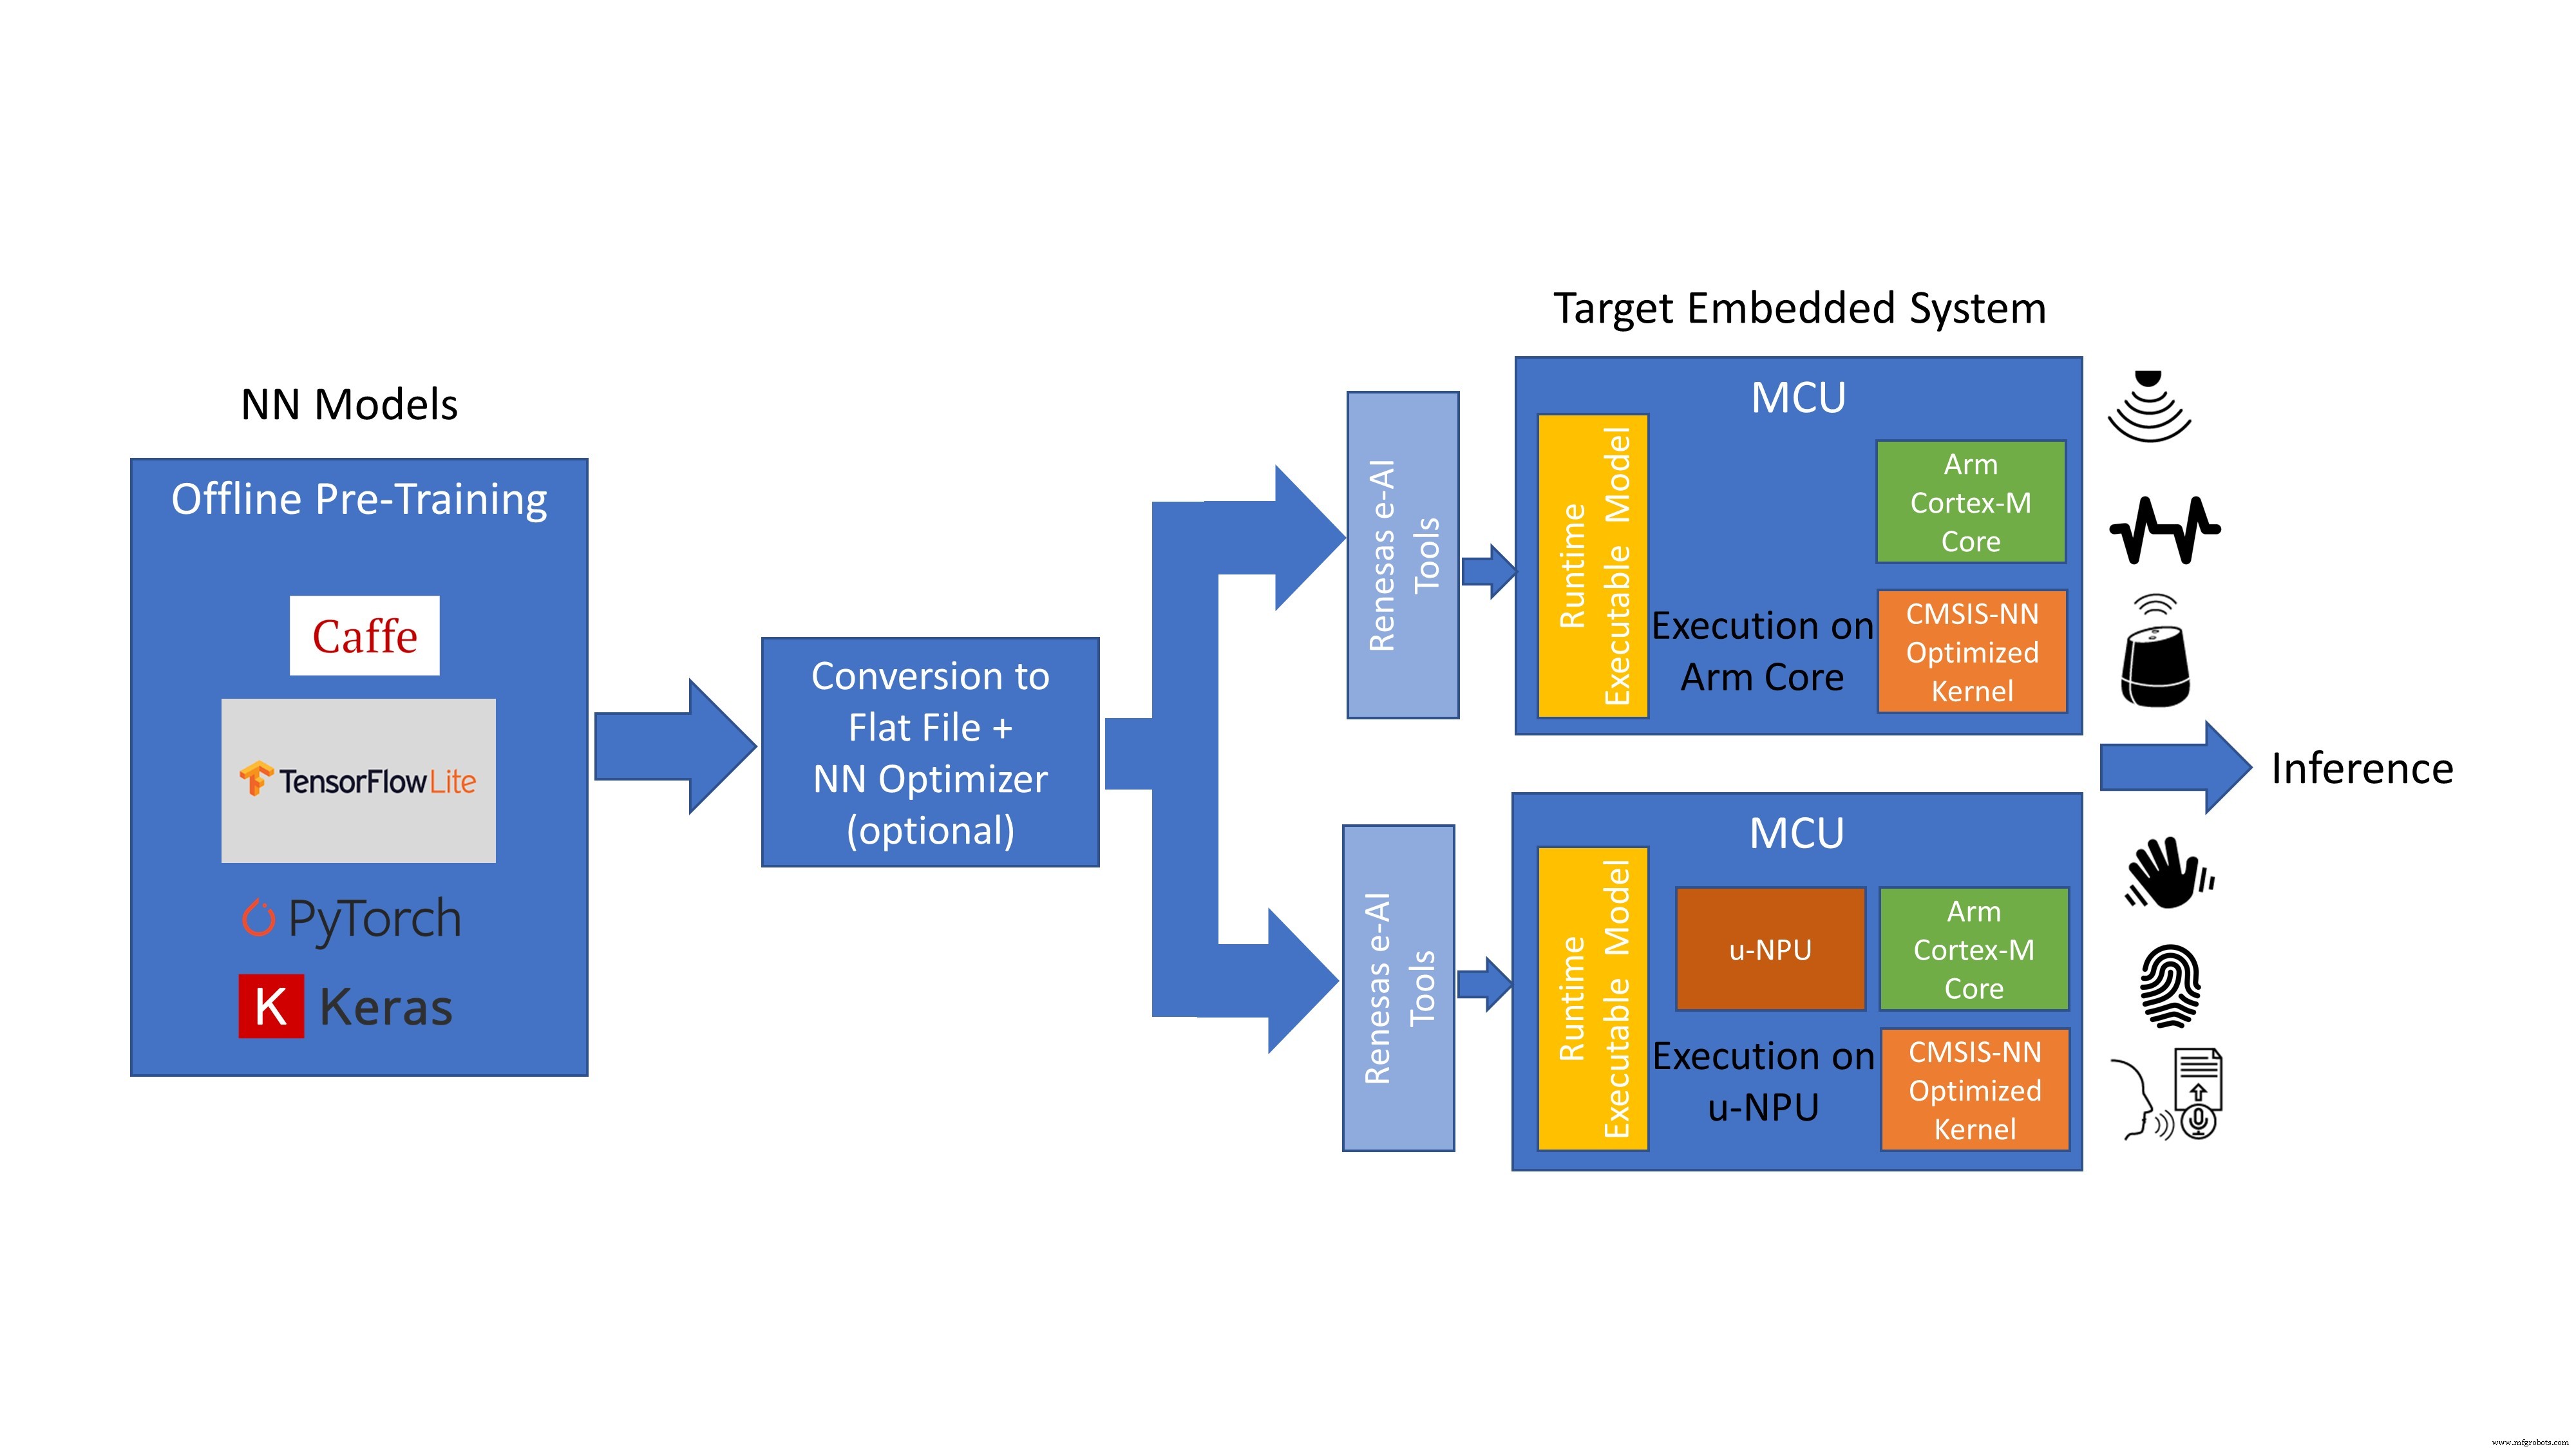
- 模型转换:用厂商转换器将训练模型转为扁平缓冲格式,可选量化以减小体积。扁平缓冲再转为C代码并打包进MCU固件。
- 部署与更新:将固件烧录至MCU。当出现新数据类别时,可在云端重新训练模型,通过空中下载(OTA)固件升级更新设备。
假设采用Arm Cortex-M内核,MCU基础AI解决方案有两种常见架构路径:
- 纯软件执行:扁平缓冲模型在Cortex-M CPU上运行,由CMSIS-NN库加速。这种轻量级设置适合关键词识别和振动分析等任务。
- 硬件加速执行:引入微神经处理单元(u-NPU)或NN加速器。u-NPU处理大多数常见音频、语音、图像分类和目标检测工作负载,不支持的操作回退至CPU。此方案提供更高吞吐量和更低功耗。
随着MCU向MPU性能包络演进,我们预期将出现设备端学习——轻量级训练算法直接在MCU上运行。这将开辟新市场,并刺激MCU制造商大量投资。
边缘AI是未来
资源受限MCU上的边缘AI将呈指数级增长,随着MCU与MPU性能界限模糊,解锁新应用。面向嵌入式场景的精简NN模型普及将推动跨行业采用。
物联网技术