


融合双深度学习模型赋能工业自动化增强
深度学习是数据分析师武器库中的利器,在工业应用等不同领域不断拓展新用途。核心原理:利用海量数据构建模型以实现精准预测。
考虑一个工业自动化工程师需融合两个深度学习模型的小案例:某手机厂产线生产多款手机。计算机视觉配合深度学习算法执行质检。现产线生产手机 A 和 B,模型 A、B 分别负责 A、B 质检。新推出手机 C,工厂可能需新模型 C 质检。从头训练新模型需海量数据与时间。
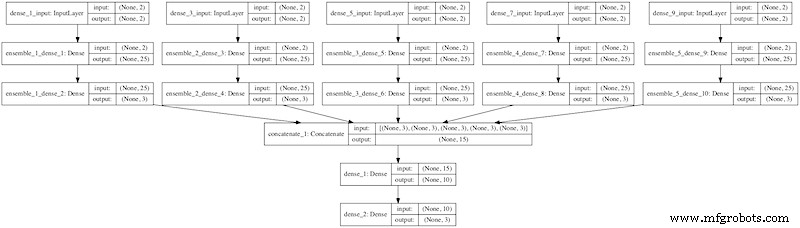
另一种思路:融合模型 A 与 B 的学习成果构建模型 C,微调权重即可胜任质检。另一融合场景:新模型需同时执行两项任务。可融合两个模型:一个擅长大数据集分类,一个擅长预测。
集成学习
融合多个深度学习模型称为集成学习。旨在获得更优预测、分类或其他深度学习功能,也可创建融合不同模型功能的新模型。相比从零训练,创建新模型优势显著:
- 所需训练数据极少,因大多学习来自融合模型
- 构建融合模型耗时远少于从头训练
- 计算资源需求更低
- 新融合模型准确率与能力超越被融合的原模型
鉴于诸多优势,集成学习常用于创建新模型。融合不同模型需相应深度学习算法、包、训练模型,主流高级算法多用 Python 编写。掌握 Python 及相关深度学习工具是融合模型的前提。就绪后,可实施以下技术融合不同深度学习算法。
(加权)平均法
以两模型平均值为新模型,最直接的融合方式。简单平均得到的模型准确率已超原两模型。为进一步提升精度,可用加权平均。权重依据模型性能或训练量分配。此法将两不同模型融合为新模型。
Bagging 法(装袋法)
同一深度学习模型可有多个迭代版本。不同迭代用不同数据集训练,改进程度不同。融合同一模型的不同版本即 Bagging 法。方法论同平均法:以简单或加权平均融合不同版本。此法消除单一模型积累的确认偏误,使新模型更准确高性能。
Boosting 法(提升法)
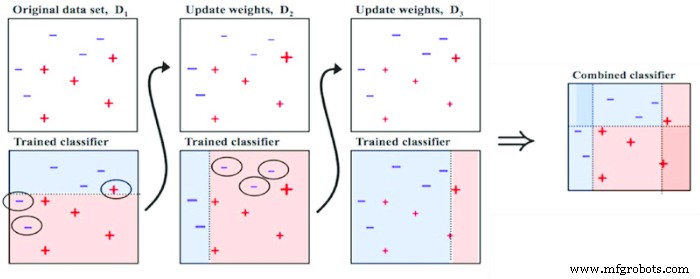
类似模型反馈回路。用模型性能调整后续模型,形成正反馈回路,累积所有促成成功的因素。Boosting 减少模型偏差与方差,因负面因素在后续迭代中被过滤。可分权重提升与残差提升两种方式。
Concatenation 法(拼接法)
用于将不同数据源融合进同一模型。接收不同输入并拼接至同一模型,结果数据集维度高于原始数据。多次顺序拼接会导致维度爆炸,引发过拟合、关键信息丢失,降低融合模型性能。
Stacking 法(堆叠法)
集成深度学习堆叠法整合不同方法,利用前序迭代性能提升前序模型。在堆叠模型中加入加权平均元素,增强子模型正向贡献。亦可加入 Bagging、Concatenation 技术。融合不同组合技术可改善融合模型性能。
融合深度学习模型的方法论、技术、算法不可胜数且持续演进。未来将有更优技术完成同类任务。核心要点:
- 融合深度学习模型即集成学习
- 融合旨在提升深度学习模型性能
- 组合构建新模型需更少时间、数据、算力
- 最常用方法:多模型平均,加权平均提升精度
- Bagging、Boosting、Concatenation 为其他融合方法
- 堆叠集成学习融合多种技术构建模型
物联网技术