


雾计算详解:云边协同实现更快更智能的数据处理
讲雾计算前,先夯实云计算认知。云计算指按需获取算力、存储、计算资源,无需本地硬件与主动运维。图1展示多厂区工业云部署通用架构。
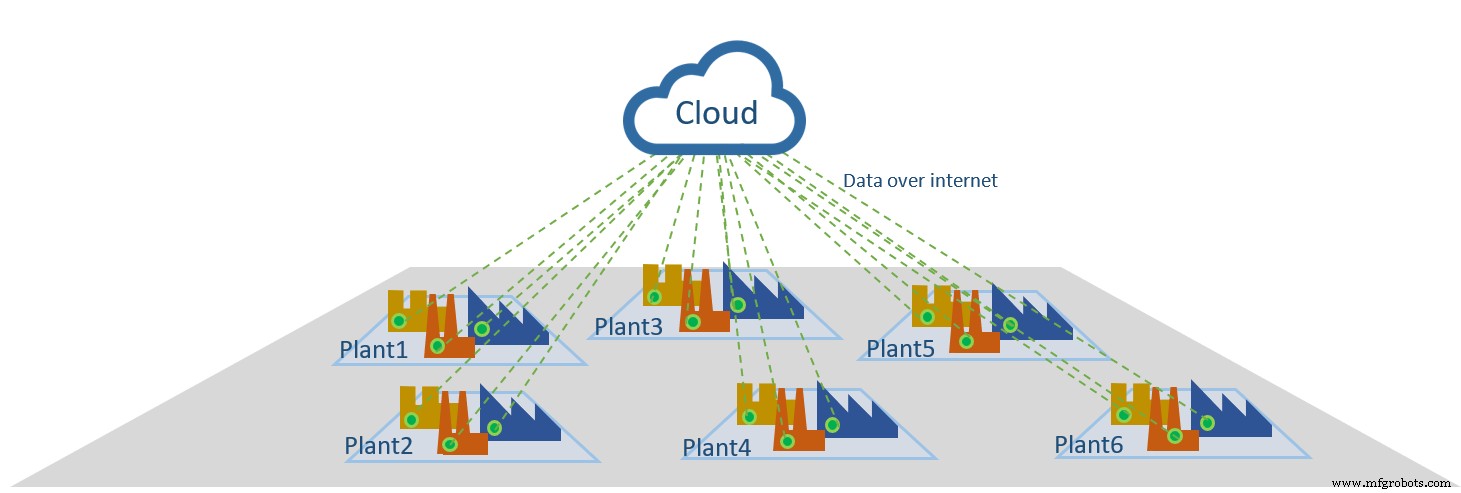
图1:云计算架构,作者提供
云采用模型主流有IaaS、PaaS、SaaS,组织诉求决定最佳适配。IEEE 1934定义雾计算为:"分布式系统级横向架构,将计算、存储、控制、网络资源服务分布于云到物端的连续体上,支持行业垂直应用,使服务贴近数据源头,跨越事物、网络边缘、云及多协议层"。
简而言之,雾计算将部分云资源下沉至靠近终端设备侧。每厂区LAN层部署雾计算节点聚合数据,裁决本地处理与上云分流,充当本地设备与远程服务器的中介。核心收益:
- 减少云连接数量
- 加速本地处理——雾节点发送汇总后的有效数据上云,多厂区数据融合分析(图2)
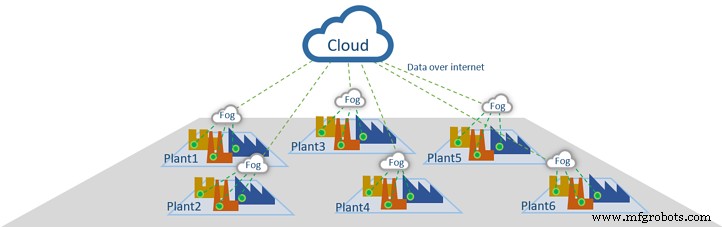
图2:雾计算架构,作者提供
雾计算与边缘计算的区别
业界对"雾"与"边"定义分歧大:有人视为同义,有人强调差异。工业制造领域两者均旨在比传统云架构更高效采集处理本地资产数据。关键差异在于处理与"智能"的最终落地位置。
例:传感器本地存储30天分钟级原始数据,每小时仅传汇总数据至局域网计算资源,小部分转发云端。这大幅降低传输量,且留存详细历史供溯源。你对边/雾的定义取决于在原始采集、存储、计算资源使用处如何划界。
雾计算核心收益
设想聚合分析100个传感器数据所需算力,10,000个呢?存储、流量、带宽随数据源呈指数增长。雾计算助你:
- 降低网络时延与数据流量
- 提升有效带宽利用率
- 垂直隔离网络
- 高效弹性扩展部署
- 掌控隐私与数据安全
采用雾计算可分步构建部署"智能"高效IIoT方案。思维重构:不纠结"云/雾/边二选一",而问"哪种组合最适配我的特定需求?" 视为协同适配而非非此即彼。
工业技术