


Python XML 解析实战:使用 minidom 与 ElementTree 详解
什么是 XML?
XML(可扩展标记语言)旨在高效存储和传输结构化数据,广泛用于系统和应用间的信息交换。
Python 提供强大的库解析和操作 XML 文档。但解析前必须将整个文档加载入内存。本教程演示如何使用 Python 的 xml.dom.minidom 和 xml.etree.ElementTree 模块读取、检查和修改 XML 文件。
读完本指南你将能够:
- 使用
minidom解析 XML - 创建新 XML 节点
- 使用
ElementTree解析 XML
使用 minidom 解析 XML
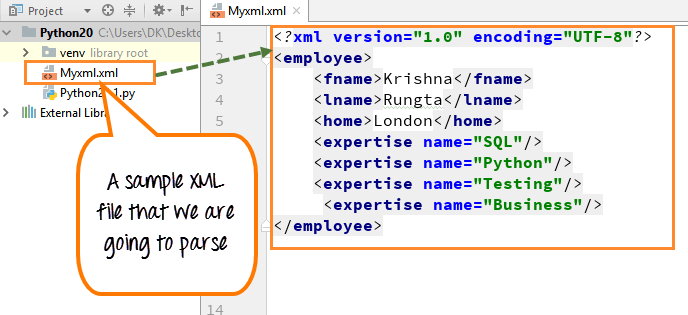
以包含员工数据的示例 XML 文件为例,文件内容如下:
步骤 1 文件列出员工的名、姓、住址,以及 SQL、Python、Testing、Business 等专长领域。
步骤 2 加载文档后,打印根元素的 nodeName 和第一个子元素的 tagName。这些是标准 DOM 对象属性。
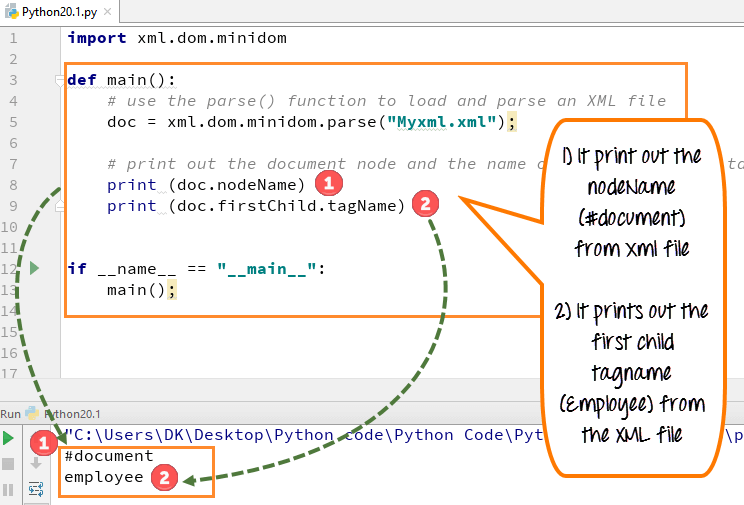
- 导入
xml.dom.minidom并加载 XML 文件 (myxml.xml)。 - 用
parse()解析文件获取文档对象。 - 获取并显示文档
nodeName和第一个子元素tagName。 - 用
getElementsByTagName()列出所有expertise元素并打印各技能。
注意: nodeName 和 tagName 遵循 XML DOM 命名惯例,初学者可能陌生。
步骤 3 可从文档提取所有技能列表。下面代码演示如何将技能名收集到集合。
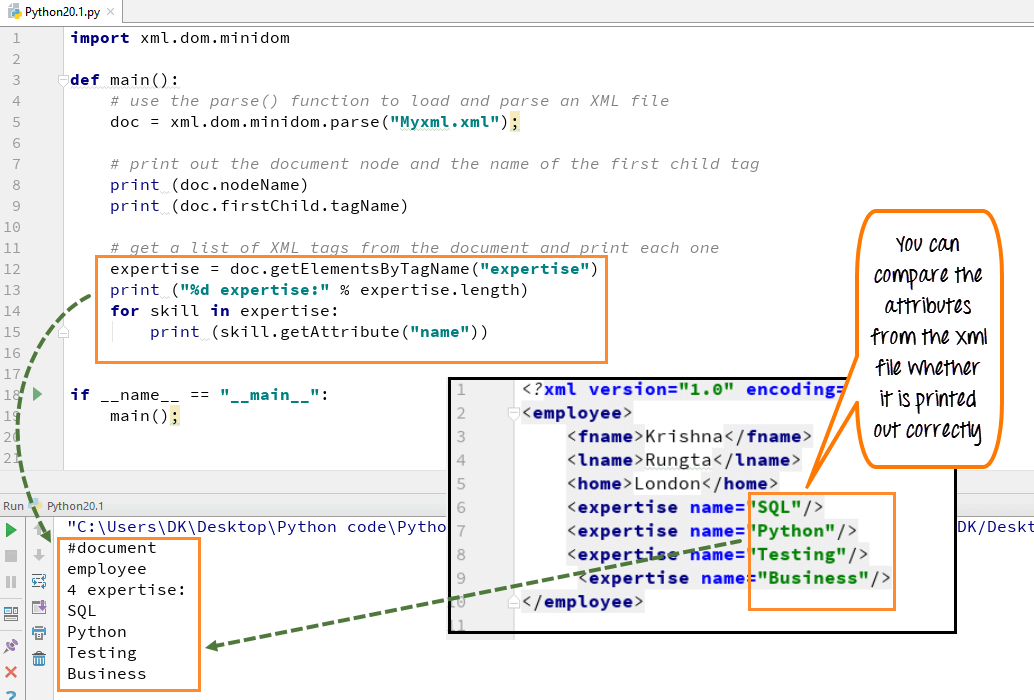
- 用
getElementsByTagName("skill")获取所有 skill 元素。 - 遍历返回列表输出每个技能的
name属性。
创建新 XML 节点
用 minidom 向现有 XML 结构添加数据很简单。示例中添加名为 “BigData” 的新 expertise 节点。
- 用
createElement("expertise")创建新元素并设置name属性。 - 将新元素追加到文档根子元素。
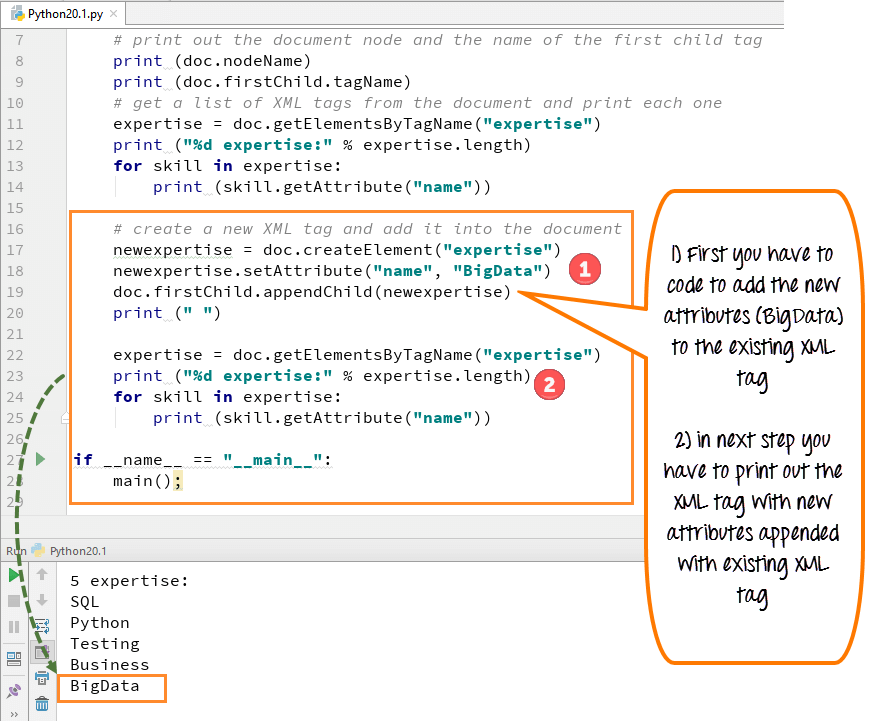
- 插入后,
expertise列表包含新增的 “BigData” 技能。
XML 解析器示例
Python 2 示例
import xml.dom.minidom
def main():
    # 加载并解析 XML 文件
    doc = xml.dom.minidom.parse("Myxml.xml")
    # 输出根信息
    print doc.nodeName
    print doc.firstChild.tagName
    # 列出现有 expertise 条目
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")
    # 添加新 expertise 条目
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print " "
    # 验证添加
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")
if __name__ == "__main__":
    main()
Python 3 示例
import xml.dom.minidom
def main():
    # 加载并解析 XML 文件
    doc = xml.dom.minidom.parse("Myxml.xml")
    # 输出根信息
    print(doc.nodeName)
    print(doc.firstChild.tagName)
    # 列出现有 expertise 条目
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))
    # 添加新 expertise 条目
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print(" ")
    # 验证添加
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))
if __name__ == "__main__":
    main()
使用 ElementTree 解析 XML
ElementTree 是轻量级 API,使 XML 操作简洁 Pythonic。适合读取大 XML 文件,避免完整 DOM 开销。
示例 XML 数据:
<data>
  <items>
    <item name="expertise1">SQL</item>
    <item name="expertise2">Python</item>
  </items>
</data>
使用 ElementTree 读取 XML:
先导入模块:
import xml.etree.ElementTree as ET
解析文件获取根元素:
tree = ET.parse('items.xml')
root = tree.getroot()
显示所有技能名的完整代码:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()
print('Expertise Data:')
for elem in root:
    for subelem in elem:
        print(subelem.text)
输出:
Expertise Data:
SQL
Python
总结
Python xml.dom.minidom 和 xml.etree.ElementTree 让开发者高效加载、分析、修改 XML 文档。minidom 提供完整 DOM 表示,适合复杂操作;ElementTree 则为轻量级解析和提取提供替代方案。
- 用
parse()加载 XML(如doc = xml.dom.minidom.parse(file))。 - 用
getElementsByTagName()检索元素。 - 用
createElement()和appendChild()创建并追加新节点。 - ElementTree 只需遍历子元素即可访问数据。
Python
- Python 文件 I/O:掌握文件操作、读写与管理
- Python strip() 方法完全指南:去除首尾空白与自定义字符实战
- Python len() 函数实战指南:测量字符串、列表、元组、字典等对象长度
- 精通 Python yield:生成器 vs return 实战指南
- Python collections.Counter:高效计数、更新与算术运算
- 精通 Python enumerate():为列表、元组、字符串、字典带索引循环
- Python 检查文件与目录是否存在:实战指南
- Python JSON:编码、解码与文件处理实战指南
- Python list.index() 详解:查找元素位置的实用指南与示例
- Python 文件 I/O:掌握输入输出操作
- Python XML 处理指南:实现跨平台数据互操作
- Java BufferedReader 读取文件:实战指南与示例