


PyTorch vs TensorFlow 2024:深度学习框架终极选型指南
深度学习框架双雄 PyTorch 与 TensorFlow 持续迭代,生态差距大幅收窄。PyTorch 占据科研主导地位,TensorFlow 深耕工业级部署。本文从可视化、图执行模式、学习曲线、部署生态、分布式训练、设备管理、真实落地案例七大维度深度对比,助您按场景决策。
核心指标对比总览
| 维度 | PyTorch | TensorFlow 2.x |
|---|---|---|
| 发起机构 | Meta FAIR (Facebook AI Research) | Google Brain Team |
| 基因血统 | Torch (Lua) → PyTorch | Theano → TensorFlow |
| 核心定位 | 科研友好、动态图、Pythonic | 产业级、静态图优化、全平台部署 |
| 可视化 | TensorBoard (原生支持) / Visdom | TensorBoard (原生、功能最全) |
| 模型部署 | TorchServe / ONNX Runtime / TensorRT / CoreML | TensorFlow Serving / TF Lite / TF.js / TensorRT |
| 移动/边缘 | PyTorch Mobile / ExecuTorch (新一代) | TensorFlow Lite (成熟、算子覆盖广) |
| 设备管理 | 显式 .to(device) / CUDA Stream 精细控制 | 自动设备放置、XLA 编译器优化 |
| 图执行模式 | 动态图 (Eager) 为主,TorchScript/Compile 静态化 | Eager 为主,tf.function/Graph 模式静态优化 |
| 学习曲线 | 平缓,Python 开发者零门槛 | 陡峭,概念多 (Graph/Session/Estimator/Keras/Functional/Subclassing) |
| 典型用户 | Meta、Tesla、Uber、HuggingFace、学术界主流 | Google、DeepMind、Airbnb、Twitter、企业级生产 |
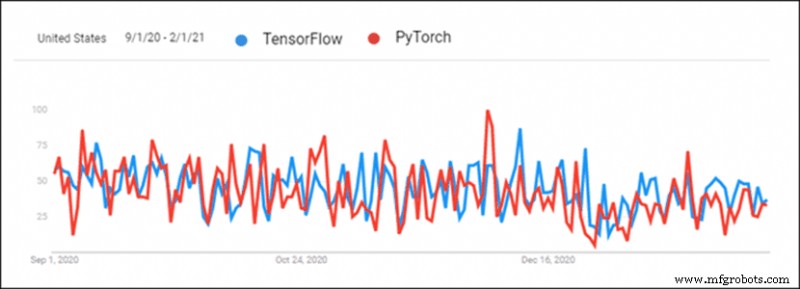
七大维度深度对比
1. 可视化工具链
TensorBoard (TF 原生):功能最全——标量/图像/音频/直方图/嵌入投影/计算图可视化/Profile 性能分析/What-If 公平性分析。插件生态丰富,支持 PyTorch/XLA/JAX 导入。缺点:重、启动慢、大规模日志渲染卡顿。
PyTorch 生态:原生集成 TensorBoard (`torch.utils.tensorboard`),体验一致。轻量替代:Weights & Biases (W&B)、MLflow、ClearML、Neptune.ai——实验追踪、超参搜索、模型注册、团队协作一体化,已成科研/工程标配。
2. 图执行模式:动静融合趋同
- 静态图:定义→编译优化→执行。利于跨设备分发、算子融合、内存规划、模型导出部署。TF 1.x 默认,TF 2.x `tf.function`、PyTorch `TorchScript`/`torch.compile` (2.0+) 支持。
- 动态图:定义即执行,Python 控制流原生支持,调试直观。PyTorch 默认,TF 2.x Eager Execution 默认。
趋势:PyTorch 2.0 `torch.compile` 引入 Dynamo+Inductor 编译器栈,动态图性能逼近静态图;TF 2.x `tf.function` 自动图捕获,两者在“开发时动态、部署时静态”上趋同。
3. 学习曲线与开发体验
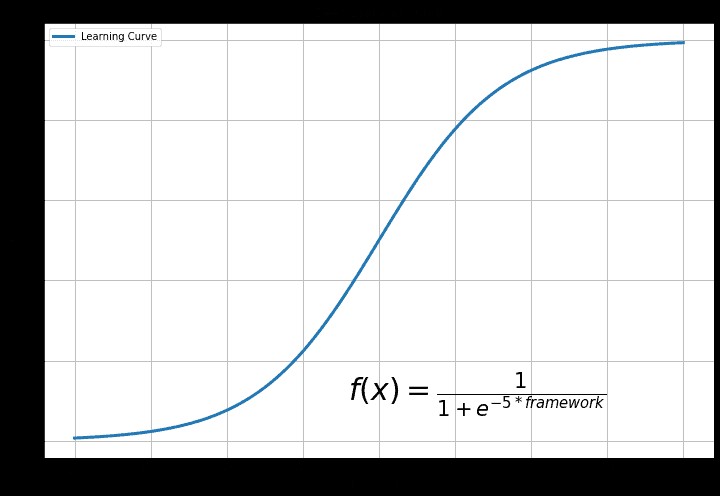
PyTorch:`nn.Module` 面向对象、自动微分透明、数据并行 `DDP` 简洁、调试可打断点、打印张量形状即时可见。教程、社区、预训练模型 (HuggingFace Hub) 最丰富。
TensorFlow:Keras 高阶 API 降低门槛,但底层 `tf.GradientTape`、`tf.function` 追踪机制、分布式策略 `tf.distribute`、SavedModel 签名、TFLite 转换等概念负担重。适合追求生产级规范、标准化流程的团队。
4. 模型部署与服务化
| 场景 | PyTorch 路径 | TensorFlow 路径 |
|---|---|---|
| 高性能推理服务 | TorchServe (多模型、A/B 测试、指标暴露) + TensorRT/ONNX Runtime 加速 | TensorFlow Serving (gRPC/REST、批处理、模型版本管理) + TensorRT |
| 边缘/移动端 | ExecuTorch (统一导出、委托后端、量化)、PyTorch Mobile | TensorFlow Lite (FlatBuffer、委托 GPU/NPU/DSP、元数据、元学习) |
| Web 浏览器 | ONNX.js / WebGPU 原型 | TensorFlow.js (WASM/WebGL/WebGPU、模型转换成熟) |
| 嵌入式/微控制器 | ExecuTorch + Delegates (ARM Ethos-U、Cadence、自定义) | TensorFlow Lite Micro (极简运行时、无 OS、KB 级内存) |
| 标准化交换格式 | ONNX (算子覆盖最全、工具链成熟) | SavedModel / TFLite / ONNX (导出支持) |
结论:TF 部署工具链更成熟、端侧覆盖更广;PyTorch 近年追赶迅猛,ExecuTorch 统一了从云到边的导出路径,HuggingFace Optimum/Torch-TensorRT 一键加速。
5. 分布式训练与并行策略
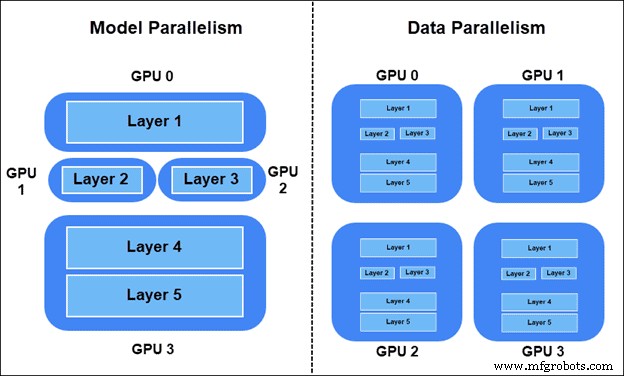
数据并行 (DP/DDP/FSDP vs MirroredStrategy/MultiWorkerMirroredStrategy):PyTorch `DistributedDataParallel (DDP)` 单进程多线程、NCCL 通信、梯度桶重叠通信计算,易用性强;`FullyShardedDataParallel (FSDP)` ZeRO-3 级参数/梯度/优化器状态分片,训练万亿参数模型。TF `MirroredStrategy` 单机多卡、`MultiWorkerMirroredStrategy` 多机、`ParameterServerStrategy` 参数服务器模式。
模型并行:PyTorch `PipelineParallel` (GPipe/1F1B)、`TensorParallel` (Megatron-LM 风格)、`torch.distributed.tensor.DeviceMesh` 统一张量并行抽象。TF `ModelParallel` (Mesh TensorFlow 演进)、Keras `ModelParallelism` API。
生态集成:PyTorch 深度绑定 Megatron-DeepSpeed、ColossalAI、YaFSDP;TF 结合 XLA/SPMD、GShard、Pathways。
6. 设备与内存管理
TensorFlow:自动放置 GPU、内存增长模式 (`tf.config.experimental.set_memory_growth`)、XLA 编译器融合算子、内存规划。优点:零配置;缺点:显存碎片化、OOM 难定位、无法精细控制多流并发。
PyTorch:显式 `.to('cuda:0')`、`torch.cuda.set_device()`、CUDA Stream 手动管理、显存缓存分配器 (Caching Allocator) 可调参数 (`max_split_size_mb`)、`torch.cuda.memory_stats()` 精细诊断。优点:可控、可调试;缺点:需开发者理解 CUDA 基础。
7. 真实世界落地图谱
| 领域 | PyTorch 典型案例 | TensorFlow 典型案例 |
|---|---|---|
| 大语言模型 | LLaMA/Mistral/Bloom 训练微调 (HuggingFace/FSDP/DeepSpeed) | PaLM/LaMDA/GLaM (Google 内部)、TensorFlow LLM 生态较弱 |
| 计算机视觉 | Detectron2、MMDetection、YOLOv8、Segment Anything (SAM) | TensorFlow Object Detection API、MediaPipe、EfficientNet 官方实现 |
| 推荐系统/广告 | Meta DLRM、TorchRec (大规模稀疏嵌入并行) | Google Wide & Deep、DLRM TF 版、TF Recommenders (TFRS) |
| 自动驾驶 | Tesla Autopilot (PyTorch 重写)、Wayve、Comma.ai | Waymo (TF/XLA)、NVIDIA DriveWorks (TF 插件) |
| 科学计算 | DeepMind AlphaFold (JAX)、PyTorch Geometric (图神经网络) | DeepMind 早期 TF、TensorFlow Probability (概率编程) |
| 生产级 NLP 服务 | HuggingFace Inference API、TGI (Text Generation Inference) | Google Cloud Vertex AI、TF Serving 企业级部署 |
2024 选型决策树
- 科研/论文复现/快速原型/学术发表 → PyTorch (社区最活跃、预训练模型最全、动态图调试最爽)
- 生产环境高吞吐推理服务、边缘/移动端部署、TF 生态成熟组件 (TFX/TFLite/TFJS) 强依赖 → TensorFlow
- 大模型训练 (LLM/多模态) → PyTorch + FSDP/DeepSpeed/Megatron (生态完胜)
- 团队 Python 技能强、偏好软工规范 (类型检查/单测/CI/CD) → PyTorch
- 团队偏好声明式配置、标准化流水线、Kubeflow/TFX 原生集成 → TensorFlow
- 跨框架迁移:ONNX 互转、HuggingFace Optimum 统一接口、PyTorch 2.0 `torch.export` 统一导出,迁移成本已大幅降低
结语
PyTorch 与 TensorFlow 已进入“动静融合、生态互通、工具链趋同”新阶段。选择框架本质是选择背后的工程文化与生态体系:PyTorch 代表“研究者优先、Pythonic、极客可控”;TensorFlow 代表“生产级标准化、跨平台部署、Google 级工程规范”。建议团队核心技术栈统一,避免双栈维护成本;新项目默认 PyTorch 2.x,除非有明确 TF 独有依赖 (TFLite Micro/TFX/Vertex AI 深度绑定)。
云计算