


读懂云服务中断:成因、影响与防范策略
IT 对云服务的依赖日益加深,因云服务中断导致停机和收入损失的可能性也随之增加。超 60% 使用公有云的组织报告 2022 年因这些事件遭受损失,故中断并非企业不太可能面对的罕见事件。
但中断是彻底弃用云的充分理由吗?还是说尽管偶尔停机,仍应坚持这种基础设施类型?
本文梳理关于云服务中断的一切。我们列举主要成因、分析惊人统计数据、展示如何最小化云停机影响,并回顾近年最具影响力的中断事件。
什么是云服务中断?
云服务中断是指云提供商服务对最终用户不可用的一段时间。供应商基础设施瘫痪(因漏洞、电力故障等),客户失去对云端资产的访问,直到提供商修复问题。
从影响看,本地数据中心宕机与云中断无异。两种情况下都会失去 IT 资产访问权,但云计算的“甩手掌柜”模式增加几个独特考量:
- 云中断故障可见性极低,用户通常不知何去何从
- 提供商团队负责修复错误,客户不参与恢复过程
- 因无可见性和控制权,无法知晓服务何时恢复
同本地硬件一样,云中断分两类:
- 计划内(通常因计划维护发生)
- 非计划内(提供商遇到意外错误须执行恢复措施时发生)
最新研究显示,非计划中断成本比计划停机高 35%(本地和云均适用)。价差源于意外事件识别修复耗时更长——中断持续越久,损害越大。
与本地硬件相比,云基础设施导致中断更频繁但严重程度较低。因无托管系统能提供 100% 正常运行时间,客户愿为云计算优势容忍偶发中断。市场增长也印证此意愿——2024 年云将占全球 IT 支出 14.2%(2020 年为 9.1%)。
云中断成因
云中断源于提供商控制内外的多种原因。最常见成因列表:
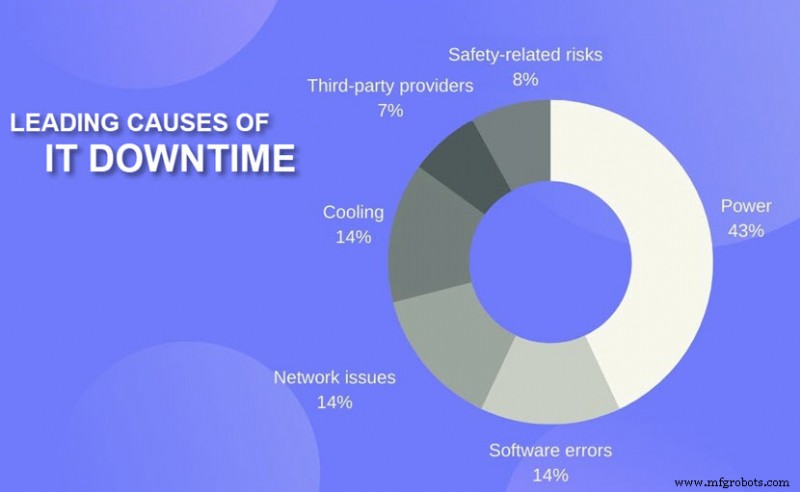
- 停电:电力相关问题导致 43% 所有重大停机和财务损失的云中断。不间断电源 (UPS) 故障是电力事故头号原因
- 网络安全:分布式拒绝服务 (DDoS) 等网络攻击用海量流量淹没数据中心。此时最终用户无法通过同一网络基础设施访问服务。其他威胁(如勒索软件或 SQL 注入)可能迫使提供商关闭服务离线修复
- 人为错误:单条错误指令或布线失误可瘫痪整个 IT 基础设施。人为错误导致物理和软件问题引发中断
- 技术问题:云服务依赖复杂硬件技术体系,长期潜伏的错误可导致云中断
- 软件漏洞:云数据中心常见故障和漏洞。常见罪魁祸首包括数据格式漏洞、故障相关漏洞、时序漏洞、常量漏洞
- 网络问题:网络通信和第三方电信合作伙伴相关问题也是云中断常见成因
- 维护:计划维护和系统升级有时导致中断,但最终用户通常提前知晓
- 环境因素:飓风、火灾、雷暴、地震等事件也触发云停机,或因威胁设施安全、或因破坏区域电网
- 更复杂的部署:更复杂的部署模型(如混合、分布式、多云)增加数据中心运营复杂度,创造更多出错机会
云宕机时会发生什么?
最好情况:云中断仅持续几分钟,影响少量用户或服务。最坏情况:中断使客户业务瘫痪半天或更久。公司失去对所有云端资产访问,被隔离至中断结束。
虽具威胁,但第三方提供商错误仅导致 2021 年 7% 的严重中断。严重中断须涉及以下一项或多项:
- 重大财务损失
- 声誉受损
- 合规违规
- 人员伤亡
虽有更迫切担忧(如下图环形图所示),但请记住平均每分钟停机成本 $5,600(企业级达 $9,000/分钟)。若无准备(无数据备份、灾难恢复等),云中断可能使服务停摆并重创利润。
仅小部分业务在云端的公司受中断影响较小。例如仅在云托管邮件,即使一天中断也非灾难性。可等待事件结束或以降级功能运行应用,但若云运行 IoT 平台或处理支付,此策略失效。
某些情况下云中断导致永久数据丢失(丢失量取决于备份频率)。严格行业客户若中断导致数据泄露或泄漏需承担法律罚款,故决定云存储内容时务必谨慎。
用户能做什么?
公司为减轻云中断影响采取的措施:
- 消除单点故障:为每个关键任务 IT 组件准备备份,或在本地服务器室、或在次级提供商处。云宕机时执行故障转移(切换至备用服务器、硬件组件、网络等)确保业务连续性
- 制定应急预案:灾难恢复计划为中断时团队行动提供分步策略。该计划提供保护数据、执行故障转移、确保业务连续性、恢复运营的指令。及时规划云中断避免停机期间浪费时间评估最佳行动方案
- 投资更高可用性 SLA:若关键业务无法容忍长时间云中断,寻找更高可用性服务等级协议 (SLA),如保证 99.999% 正常运行时间(每年最多 5.25 分钟停机)。这些合同更贵,但保持服务在线成为云提供商更高优先级
- 定期数据备份:备份确保云中断损坏或删除数据库时团队有方式恢复文件近期版本。理想情况下备份应自动进行,频率每小时至每天一次(视关键任务程度而定)
- 尽早检测中断:团队建立的任何额外云监控能力有助于实时识别中断,而非等待提供商通知。此处列出最佳云监控工具以改善停机检测并确保及时故障转移
近年最大云中断事件
云中断使用云时不可避免,即使最流行提供商(如 Azure、AWS、Google Cloud)也难免停机。回顾近年最重大云中断事件。
Azure 中断(2021 年 10 月)
2021 年 10 月,Microsoft Azure 遭遇中断,虚拟机服务瘫痪六小时。中断期间许多用户无法部署新虚拟机或更新扩展。基本服务管理操作(如启动、创建、删除)也报错。
云中断成因是虚拟机查询无法检索工件所需版本数据。恢复后报告显示,软件错误发生在 Microsoft 迁移其某虚拟机架构时。
Google Cloud 中断(2021 年 11 月)
Google Cloud 于去年 11 月中旬宕机约两小时,影响:
- Home Depot
- Snapchat
- Etsy
- Discord
- Spotify
受影响网站访问时显示 404 错误。Google 报告云中断成因是负载均衡网络配置故障。
AWS 中断(2021 年 12 月)
大量连接活动激增淹没 AWS 旗舰设施某网络设备,影响多个网站和应用。著名“受害者”包括:
- Amazon 网站
- Prime Video
- Netflix
- IMDb
- PlayStation Network
数据中心问题导致 AWS 内部网络严重延迟。客户应用遭受连锁效应,约七小时流量延迟或完全关闭。
IBM 两次后续中断(2022 年 1 月)
IBM 基础设施问题影响达拉斯区域云服务超五小时。内部团队解决问题但意外导致额外一小时虚拟私有云问题。次级问题影响全球用户,含美国、日本、加拿大、德国。
AWS/Slack 中断(2022 年 2 月)
Slack 于 2 月遭遇 AWS 云资源中断,导致通信平台无法正常使用五小时。超 11,000 报告用户无法:
- 发送或接收消息
- 上传文件
- 加入频道
- 启动桌面应用
Slack 团队未共享云中断原因,恢复后要求所有受影响用户重启应用并清除缓存。
iCloud 中断(2022 年 3 月)
3 月因云中断十五项主要 Apple 服务宕机四小时,包括:
- App Store
- Apple Maps
- Apple TV
Apple 企业和零售系统也宕机。公司后续披露根因是域名系统 (DNS) 相关问题。
Google Cloud 中断(2022 年 3 月)
2022 年 3 月 8 日,Google Cloud 用户遭受服务错误两个半小时。Spotify 和 Discord 受影响。
处理配置的 Traffic Director 代码变更导致错误。恢复后报告称,错误代码变更忽略配置数据格式迁移,导致平台无意删除用户编程。
Atlassian 中断(2022 年 4 月)
年度最大 Atlassian 中断始于 4 月 5 日,终于 4 月 18 日(部分用户 4 月 8 日起恢复服务)。公司解释中断源于团队沟通不畅和事件响应计划规划不善。
虽此云中断对部分用户持续近两周,但无客户数据重大丢失报告。不过 Trello 和 Jira 这两款旗舰产品用户均受影响。
Microsoft Azure 中断(2022 年 6 月)
6 月 7 日,Azure 客户无法连接托管在东部美国 2 区域(主要弗吉尼亚州)的资源。中断约十二小时,未影响依赖区域冗余基础设施的用户。受影响服务包括:
- Application Insights
- Log Analytics
- Managed Identity Service
- Media Services
- NetApp Files
罪魁祸首是某本地数据中心突发电力振荡,导致空气处理单元 (AHU) 关闭。
Cloudflare 中断(2022 年 6 月)
6 月 Cloudflare 意外中断导致重大中断持续一个半小时,瘫痪热门网站:
- Discord
- Shopify
- Fitbit
- Peloton
旧金山供应商解释非计划停机源于其 19 个数据中心网络配置变更。
切勿忽视云中断规划的价值
近年云中断案例传递明确信息:虽云是 IT 游戏规则改变者,但技术非万无一失。关心最终用户和应用可用性的公司必须为偶发停机做好准备,这使备份和灾难恢复 (BDR) 成为使用云资源的组成部分。
云计算