


利用DSP实现边缘端实时音频AI
利用DSP实现边缘端实时音频AI
机器学习曾局限于资源近乎无限的云服务器,正迁移至边缘设备。更低延迟、成本降低、能效提升和隐私增强推动这一转变。例如,自动驾驶汽车无法承受将数据发送云端进行行人识别的延迟,带宽成本也可能让云端语音识别望而却步。
边缘处理为何重要
数据传输与本地推理的能量权衡至关重要。若执行不高效,复杂ML工作负载会迅速耗尽设备电池。边缘推理还能将语音口述邮件等敏感数据留在设备端,保护用户隐私。
低功耗常开语音唤醒
关键词检测(如"Hey Siri"或"OK Google")是最早的边缘ML用例之一。在通用应用处理器上运行此类检测可消耗100mW以上,迅速耗尽智能手机电量。早期手机将算法移至功耗<5mW的小型DSP,现代智能麦克风现可在专用音频ML DSP上以<0.5mW完成相同任务。
超越语音:拓展边缘能力
一旦设备支持常开音频ML,即可识别情境线索:拥挤餐厅、繁忙街道、环境音乐、超声室内特征、附近呼喊声和笑声。这些功能为设备和用户带来复杂用例收益。
构建边缘AI DSP
边缘推理的顶级性能和能效需要定制硬件。下表总结了最具影响力的技术。
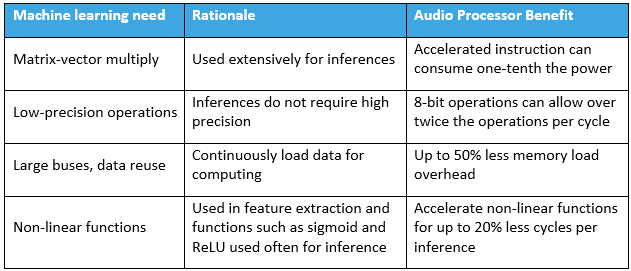
神经网络推理高度依赖矩阵-向量乘法(MVM)。融合乘累加(MAC)运算是高效MVM执行的基石。低精度算术(常为8位)足以满足推理需求,大幅降低计算复杂度。英特尔和德州仪器等厂商提供专用低精度MAC单元的处理器:TI TMS320C6745每周期执行8个8位操作数MAC,Knowles音频DSP每周期可达16个。
训练和推理都需要大量内存带宽。宽数据路径缓解压力:英特尔AVX-512支持每周期512位传输进64乘法器阵列;TI 6745使用64位总线;Knowles处理器采用128位总线,平衡芯片面积与带宽。循环架构(RNN、LSTM)需要反馈回路,对重流水线设计施加额外架构约束可能导致停顿。
音频ML流水线通常从频谱分析和特征提取开始。加速经典DSP运算——FFT、滤波器、三角和对数函数——对能效至关重要。非线性向量运算(sigmoid、ReLU等)也受益于单周期指令,进一步降低周期数和功耗。
简而言之,融合机器学习与音频信号加速的处理器能以低成本实现实时、常开推理,同时保护隐私。架构选择——多操作指令集、宽总线、专用低精度单元——在不增加高功耗的前提下维持高性能。随着专用边缘计算持续演进,可行ML用例范围将不断扩大。
Jim Steele,Knowles Corp.技术战略副总裁。
© 本文最初发表于EE Times:"DSP上的机器学习:赋能边缘音频AI。"
物联网技术