


在 PLCnext 控制器上集成机器学习:从训练到推理的完整指南
机器学习早已家喻户晓,但鲜有人知如何着手应用。希望阅读本文能帮助您理解如何利用 PLCnext 控制器开启机器学习之旅。本文将涵盖:训练首个 ML 模型、转换为 ONNX 标准、在 PLCnext 控制器上推理。为避免过度复杂,我们将使用经典的 Iris 鸢尾花数据集构建模型。
开始前,明确目标至关重要。以下简要介绍本文涉及的主题,参考资料见文末。
机器学习简介
什么是机器学习
机器学习的本质是利用统计与算法在数据集中发现模式。主要分为三类:监督学习、无监督学习和强化学习。监督学习最常用,本文采用此类。监督学习中,我们对数据打标签,明确告知机器寻找的模式。
无监督学习不打标签,让机器自行发现模式,因应用场景不明显,较少采用。
强化学习中,算法通过试错达成目标,好的动作得奖励,坏的受惩罚。Google AlphaGo 是著名案例。
鸢尾花数据集
据 Wikipedia,鸢尾花数据集包含 5 个字段:萼片长度、萼片宽度、花瓣长度、花瓣宽度和鸢尾花品种。我们的目标是根据前四个特征预测花的品种,属于分类问题。机器学习也可用于预测数值,称为回归,使用不同算法。
算法选择:决策树分类器
本文使用“决策树分类器”,非因其完美契合,而是因其直观易懂,无需复杂数学。下图展示了针对鸢尾花数据集的决策树示例。
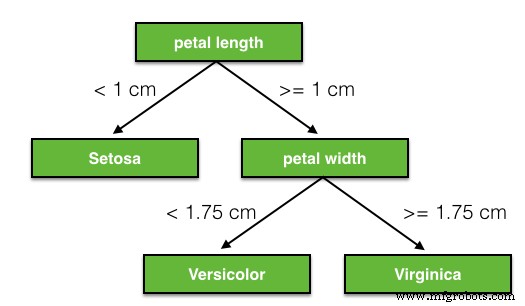
ONNX 格式
机器学习模型格式繁多,需在不同硬件和加速方式上运行。开放神经网络交换格式(ONNX)旨在解决此问题,广泛应用于 Open Office、Azure 等无数应用,几乎肯定运行在您阅读本文的设备上。
运行 ONNX 模型需 ONNX Runtime,在 ARM 处理器上有挑战,但借助提供的 Docker 镜像可顺利解决。
技术实战演练
前置条件
- AXC F 2152 控制器,固件 2021.0 LTS
- Ubuntu 20.04 虚拟机用于训练模型
- GitHub 仓库提供训练和推理脚本,Ubuntu VM 搭建超出本文范围
- PLCnext 控制器需安装容器引擎,参考此处说明
- AXC F 3152 同理可行
- 需具备基础 Python 和容器经验
训练模型
下载 GitHub 仓库内容并确保安装所有必要包。首先运行训练脚本,将模型拟合到鸢尾花数据集。以下为训练脚本关键代码片段,将生成包含训练模型的 .onnx 文件。
# 划分训练集与测试集
iris = load_iris()
X, y = iris.data, iris.target
X_train, X_test, y_train, y_test = train_test_split(X, y)
# 定义模型并用训练数据拟合,打印模型信息
clr = DecisionTreeClassifier()
clr.fit(X_train, y_train)
print(clr)
# 将模型从 sklearn 格式转换为 ONNX
initial_type = [('float_input', FloatTensorType([None, 4]))]
onx = convert_sklearn(clr, initial_types=initial_type)
with open("decision_tree_iris.onnx", "wb") as f:
    f.write(onx.SerializeToString())
在 Ubuntu 上推理验证
在开发机上运行推理脚本验证模型。运行后应输出两个整数,对应鸢尾花品种。
import numpy as np
import onnxruntime as rt

X_test = np.array([[5.8,4.0,1.2,0.2],[7.7,3.8,6.7,2.2]])

sess = rt.InferenceSession("decision_tree_iris.onnx")
input_name = sess.get_inputs()[0].name
label_name = sess.get_outputs()[0].name
pred_onx = sess.run([label_name], {input_name: X_test.astype(np.float32)})[0]
print(pred_onx)
# output: [0 2]
在 PLCnext 上推理
使用 sFTP 客户端将 .onnx 和 inference.py 传输到 PLCnext 控制器的 /opt/plcnext/onnx 目录。以 root 身份执行:
balena-engine run -it --name onnx -v /opt/plcnext/onnx/:/app pxcbe/onnx-runtime-arm32v7
运行推理脚本:
cd /app
python3 /app/inference.py
若一切顺利,输出将与 Ubuntu VM 一致!恭喜,您已完成全流程。现在去改变世界吧!
如何在实际应用中落地?
分类鸢尾花虽有趣,但在逻辑控制器上鲜有实际应用。您需构建自己的模型并创建 API 供推理调用。可通过 OPC UA 传递数据,或构建自定义 REST 端点。无论如何,您需要编写比本文提供更多的代码。
考虑到构建镜像耗时数日且曾熬夜,建议基于提供的镜像构建您的镜像。参考资料中有构建 Python 容器应用的优质资源。
参考资料
- What is Machine Learning?
- Iris flower data set - Wikipedia
- Decision Tree for Iris Dataset
- ONNX 官网
- PLCnext Docker 入门
- 5 分钟容器化 Python 应用
- ONNX 模型库
工业技术