


使用TensorFlow构建变分自编码器:实战指南
掌握自编码器基础,理解变分自编码器如何增强其能力,并演练TensorFlow分步实现。
人工智能重塑无数领域,数据压缩不例外。自编码器——特别是其变分变体——提供高效表达的生成式压缩方案。本指南拆解核心概念,带你用MNIST数据集完整走通TensorFlow实现。
自编码器应用
自编码器广泛应用于神经机器翻译、药物发现、图像去噪、异常检测等领域。其学习压缩信息表征的能力使其成为现代ML流水线首选工具。
自编码器关键组件
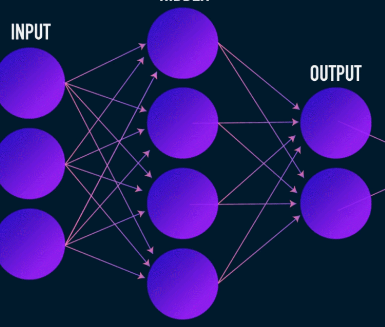
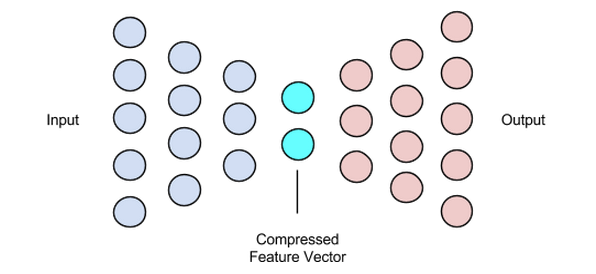
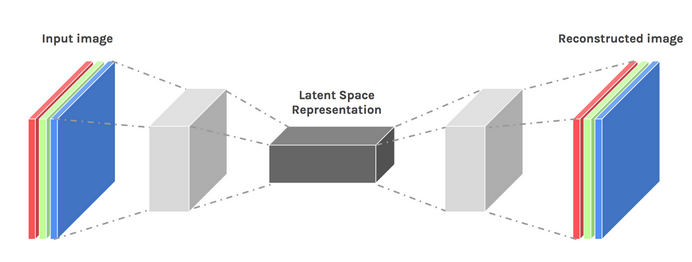
区别于典型神经网络,自编码器设瓶颈强制低维潜在表征。架构含三大部分:
- 编码器 — 将输入数据压缩为潜在向量
- 瓶颈(潜在向量) — 存储最显著特征
- 解码器 — 从潜在向量重构输入
编码器和解码器通常为前馈网络,实践中常用专用变体——图像用卷积、文本用循环。
编码器
编码器将高维输入(如28×28像素图像)映射为紧凑潜在向量。训练中优化权重使潜在向量捕获关键信息,使解码器以最小损失重构输入。
瓶颈(潜在向量)
潜在向量维度权衡:过小丢失关键细节;过大削弱压缩并膨胀计算。选择合适维度对模型性能至关重要。
解码器
解码器镜像编码器,将潜在向量映射回原始数据空间。通常用转置卷积或上采样层恢复空间分辨率。
训练自编码器
自编码器端到端用基于梯度优化器(如Adam)训练。目标最小化重构损失,量化输入与重构间差异。
损失函数
常用选择含L1、L2、均方误差(MSE)。各衡量输出与输入接近度,适配生成式重构任务。
网络变体
多层感知机(MLP)可作编码器/解码器,但卷积神经网络(CNN)因空间感知更适配图像数据。循环网络擅长文本等序列数据。
标准自编码器缺乏创造力——只能复现训练见过的数据。引入变分框架随机性解锁生成能力。
变分自编码器(VAE)
VAE在标准架构两处修改:
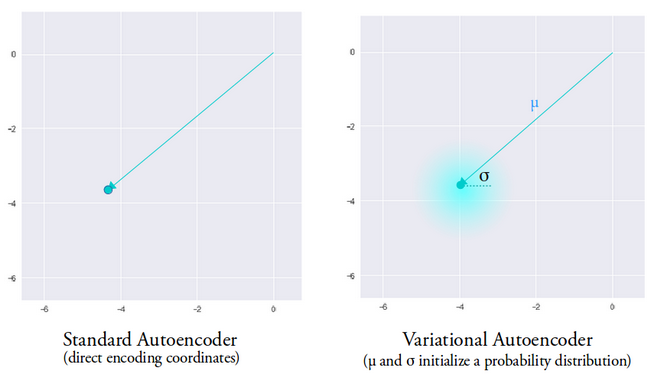
- 编码器输出均值向量和方差向量,定义高斯分布
- 损失函数加入Kullback-Leibler(KL)散度项,正则化潜在分布向单位高斯靠拢
推理时编码器从学习分布采样潜在向量,使解码器生成多样真实重构。此随机性缓解确定性自编码器常见的不连续性。
TensorFlow实现
下面是MNIST卷积VAE简洁、生产就绪TensorFlow实现。
数据准备
(train_images, _), (test_images, _) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape(-1, 28, 28, 1).astype('float32')
test_images = test_images.reshape(-1, 28, 28, 1).astype('float32')
train_images /= 255.
test_images /= 255.
train_images[train_images >= .5] = 1.
train_images[train_images < .5] = 0.
test_images[test_images >= .5] = 1.
test_images[test_images < .5] = 0.
TRAIN_BUF = 60000
BATCH_SIZE = 100
TEST_BUF = 10000
train_dataset = tf.data.Dataset.from_tensor_slices(train_images).shuffle(TRAIN_BUF).batch(BATCH_SIZE)
test_dataset = tf.data.Dataset.from_tensor_slices(test_images).shuffle(TEST_BUF).batch(BATCH_SIZE)
VAE模型定义
class CVAE(tf.keras.Model):
    def __init__(self, latent_dim):
        super(CVAE, self).__init__()
        self.latent_dim = latent_dim
        self.inference_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(28, 28, 1)),
            tf.keras.layers.Conv2D(32, 3, strides=2, activation='relu'),
            tf.keras.layers.Conv2D(64, 3, strides=2, activation='relu'),
            tf.keras.layers.Flatten(),
            tf.keras.layers.Dense(latent_dim + latent_dim),  # mean & logvar
        ])
        self.generative_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(latent_dim,)),
            tf.keras.layers.Dense(7*7*32, activation='relu'),
            tf.keras.layers.Reshape((7, 7, 32)),
            tf.keras.layers.Conv2DTranspose(64, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(32, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(1, 3, padding='SAME'),  # logits
        ])

    @tf.function
    def sample(self, eps=None):
        if eps is None:
            eps = tf.random.normal(shape=(100, self.latent_dim))
        return self.decode(eps, apply_sigmoid=True)

    def encode(self, x):
        mean, logvar = tf.split(self.inference_net(x), num_or_size_splits=2, axis=1)
        return mean, logvar

    def reparameterize(self, mean, logvar):
        eps = tf.random.normal(shape=mean.shape)
        return eps * tf.exp(logvar * .5) + mean

    def decode(self, z, apply_sigmoid=False):
        logits = self.generative_net(z)
        if apply_sigmoid:
            return tf.sigmoid(logits)
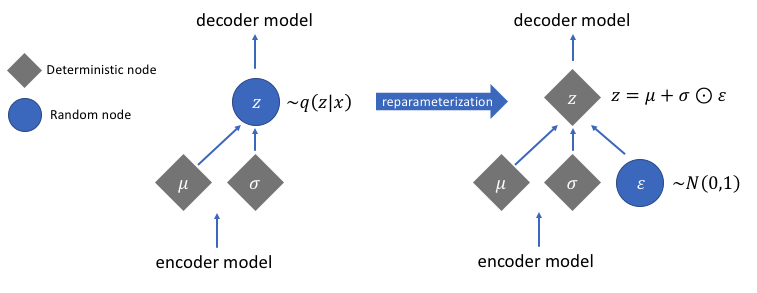
return logits关键辅助函数——encode、reparameterize、decode——封装VAE工作流。reparameterize实现重参数化技巧,使梯度穿过随机采样流动。
重参数化技巧
直接从分布采样潜在向量破坏可微性。将样本表示为z = mean + std * eps(eps ~ N(0,1)),梯度通过mean和std传播。KL散度项进一步将学习分布对齐标准正态,促进平滑潜在空间。
步骤速览
- 定义编码器和解码器架构
- 实现重参数化技巧启用反向传播
- 端到端训练,最小化重构损失加KL散度
完整代码和额外训练脚本见TensorFlow官方教程。
图片来源:Chiman Kwan(修改)
工业机器人