


神经网络训练中的局部极小值:迷思还是现实?
理解局部极小值在感知机与多层神经网络训练中的作用。
AAC神经网络系列已探讨多层感知机设计与训练诸多方面。深入局部极小值前,回顾前序文章:
- 如何用神经网络分类:什么是感知机?
- 如何用简单感知机神经网络示例分类数据
- 如何训练基本感知机神经网络
- 理解简单神经网络训练
- 神经网络训练理论导论
- 理解神经网络学习率
- 多层感知机进阶机器学习
- Sigmoid激活函数:多层感知机激活
- 如何训练多层感知机神经网络
- 理解多层感知机训练公式与反向传播
- Python实现的神经网络架构
- 如何用Python创建多层感知机神经网络
- 神经网络信号处理:神经网络设计验证
- 神经网络训练数据集:如何训练验证Python神经网络
- 神经网络需要多少隐藏层和隐藏节点?
- 如何提高隐藏层神经网络准确率
- 将偏置节点纳入神经网络
- 理解神经网络训练中的局部极小值
训练神经网络是复杂优化任务。虽很少需理解每个数学细节来构建有效模型,但局部极小值现象仍是关键理论考量。
为何局部极小值重要
历史上,局部极小值被视为训练重大障碍,特别是复杂输入-输出映射。近期研究——如损失曲面几何研究(Choromanska等,2015;Dauphin等,2014)——表明现代架构和训练启发式降低了此问题严重性。尽管如此,理解局部极小值有助于领会基于梯度优化器如何在高维损失地形导航,及为何特定训练策略能逃离次优点。
定义局部极小值
考虑简单二次误差曲面:f(x, y) = x² + y²。产生最低可能误差的点——称全局极小值——是训练目标。完美凸碗中,梯度下降无论起始位置均收敛至此点。
实践中损失曲面远非凸。可包含多山谷和平台,如下图:
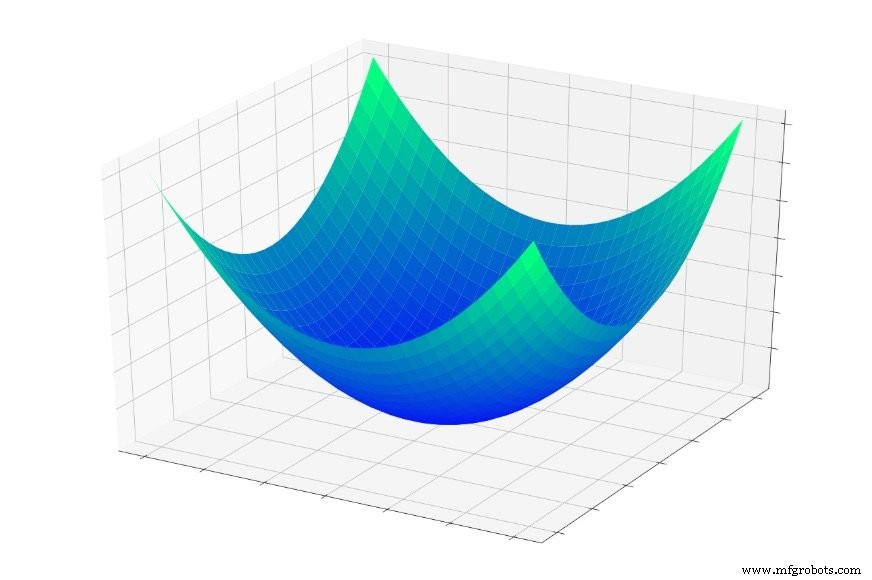
优化器步入浅盆地时,可能陷入局部极小值——该局部区域最低点——而非全局极小值。缺乏全局知识,算法无法"爬回"探索更深山谷。
我们真需要全局极小值吗?
虽达到全局极小值常关联更低训练误差,但不总等同更好泛化。在训练数据完美拟合的高表达力网络可能过拟合,降低未见样本性能。此时位置良好的局部极小值可提供更稳健解。此外,鞍点——梯度某些方向消失的平坦区域——可能比简单局部极小值构成更大挑战(Goodfellow等,2015)。
实际启示
现代训练实践通过随机梯度下降、学习率调度、动量、Adam优化器、权重初始化方案缓解局部极小值影响。集成方法和正则化(Dropout、L2)也助模型避免过拟合全局极小值。
结论
局部极小值仍是神经网络训练迷人层面。理解其影响指导架构、优化器、正则化策略选择。下文将探索具体技术——如学习率退火和自适应优化器——引导网络趋向理想极小值。
工业机器人
- 理解网络拓扑:从点对点到环形与星形
- 理解网络协议:从物理层到高级仲裁
- 人工神经网络提升无线通信性能
- 训练大型神经网络排放28.4万吨CO₂,相当于5辆车全寿命排放
- Python多层感知机添加偏置节点:方法与效果评估
- 优化隐藏层规模提升神经网络准确率
- 选择神经网络隐藏层数与节点数的实证指南
- 用Excel生成数据训练验证Python多层感知机
- 机器人光纤激光切割 vs 等离子切割:核心差异与选型指南
- STMicroelectronics 发布 STM32Cube.AI:赋能边缘设备嵌入式神经网络
- CEVA 发布 NeuPro-S:面向边缘深度神经网络推理的下一代 AI 处理器
- NIST神经网络在密集图像中检测微小几何形状准确率达97%