


先进信号处理如何实现语音助手无缝交互
智能音箱与语音控制设备快速普及,Amazon Alexa、Google Assistant等助手随每次更新更懂人类语音指令。
此界面最大吸引力在于毫不费力——零学习成本,纯自然对话。这顺滑体验背后,是将原始音频转化为清晰可执行请求的精密信号处理链路。
本文剖析语音控制方案架构,揭示赋能其生命的隐藏软硬件层。
信号流与架构
虽具体实现因产品异,基础流程一致。以Amazon Echo等智能音箱为例,关键子系统见图1。
点击查看大图
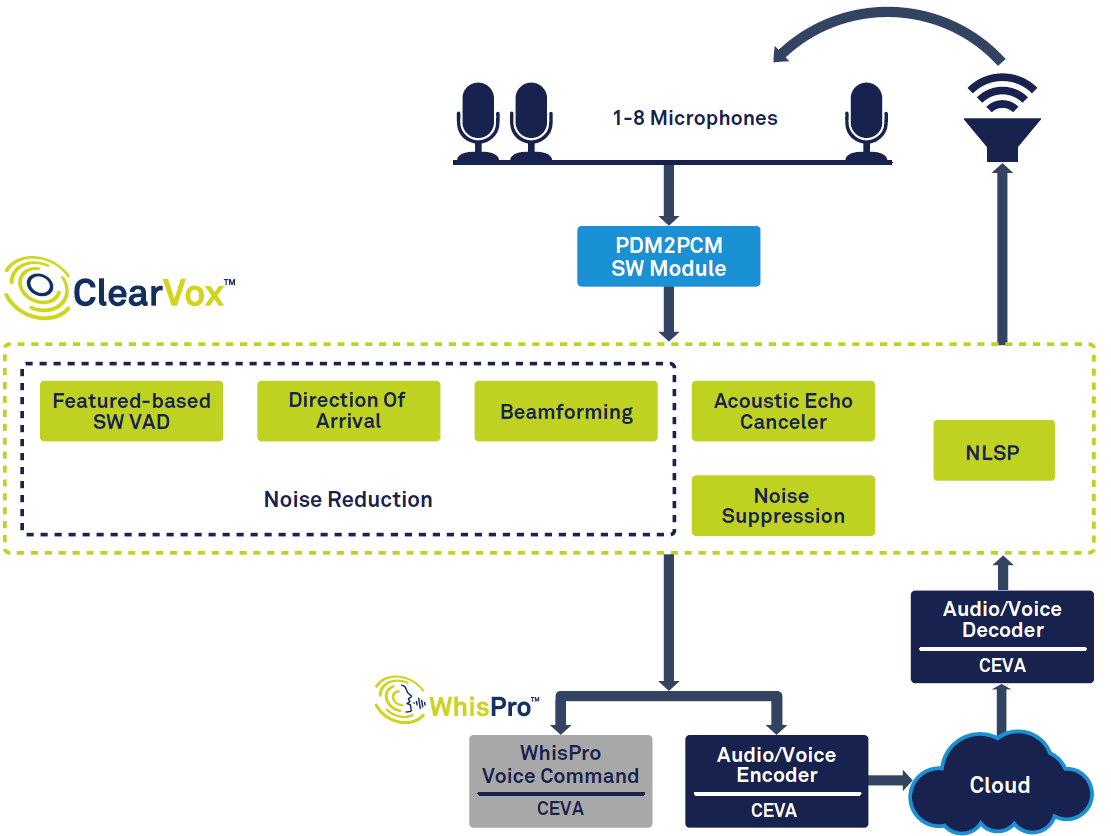
图1:基于CEVA ClearVox与WhisPro的语音助手信号链。(来源:CEVA)
链路始于语音活动检测(VAD),隔离语音片段。采集音频数字化后,经一系列前端算法增强清晰度,聚焦用户到达方向。处理后信号转往后端语音处理,可部分在设备(边缘)运行、部分在云端。最终,响应——文本或语音——经合成、解码、通过音箱数模路径渲染播放。
不同用例引入变体。如车载语音界面须应对路噪,新兴可穿戴设备要求超低功耗与极低成本。
前端信号处理
VAD与数字化后,设备须抑制非期望声音。声学回声消除(AEC)移除设备自播放引起的反射,实现播放音乐时仍能无缝"插嘴"。噪声抑制再清理残留背景嘶声。
语音控制设备分近场(耳机、耳塞)与远场(智能音箱、电视)。近场典型用1-2麦克风,远场部署3-8麦克风。后者面临更恶劣声学环境——声音随距离衰减、背景噪声恒定、混响复杂化信号提取。
远场设备采用波束成形,利用麦克风阵列时间差计算声源方向。这让系统聚焦用户、忽略反射、追踪移动、在多声源时隔离单一发言人。
唤醒词检测(如"Alexa")至关重要。持续监听引发隐私担忧;故许多系统本地执行唤醒词识别,仅在检测完整指令后上传音频至云端。
清洗后的语音样本经编码传输至云端后端深度分析。
专用解决方案
前端处理须快、准、省电——尤其电池供电可穿戴设备。通用DSP或CPU在成本、尺寸、能耗上难满足这些需求。解决方案是面向音频任务的专用应用型DSP。
CEVA ClearVox是软件套件,跨多样声学场景处理多麦克风波束成形、到达方向估计、噪声抑制、AEC。针对CEVA音频DSP优化,ClearVox提供低成本、低功耗路径实现高质量语音采集。
唤醒词检测由CEVA WhisPro负责,专属CEVA DSP的神经网络识别器。WhisPro让主处理器沉睡直至检测唤醒词,大幅降低系统整体功耗,同时保持>95%识别率。支持多触发词与自定义词汇,关乎消费者满意度。
点击查看大图
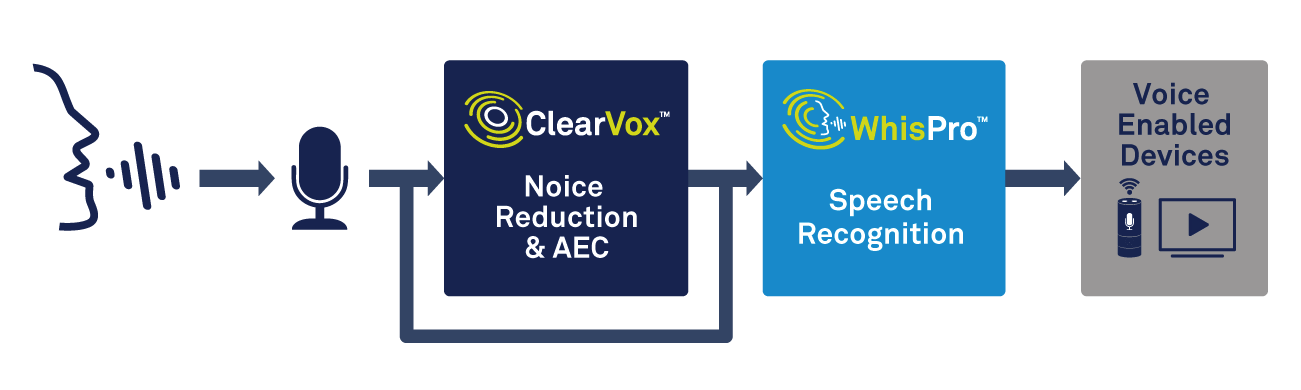
图2:使用语音处理与语音识别实现语音激活。(来源:CEVA)
语音识别:本地还是云端
音频清洗数字化后,下一步是自动语音识别(ASR)。范围跨度从简单关键词检测至全规模自然语言处理(NLP)。关键词检测适合窄域设备(如智能恒温器),实现离线即时响应。
反之,许多应用需上下文理解。"帮我找市中心附近高性价比酒店"须解析意图、实体、后续上下文——典型需远超低功耗边缘芯片能力的神经网络推理。
云端处理提供算力支撑复杂NLP,代价是延迟与联网依赖。边缘方案改进中;CEVA NeuPro AI处理器将设备端神经网络推理带至边缘,实现更智能、更快本地响应,必要时仍回落云端。
边缘与云端选择涉及权衡。本地处理擅长速度与隐私,但难应对复杂查询。云端处理扩展至复杂NLP,引入延迟与连接依赖。
结论
语音界面迅速成为日常技术基石。信号处理、ASR、AI持续进步——配合专用硬件——驱动更高精度、更低功耗、更低成本。
采用ClearVox、WhisPro、NeuPro等专用方案的OEM,可满足严苛性能、成本、功耗目标,同时缩短上市周期。
随语音技术成熟,我们可期待更自然交互与更广应用前景——这激动人心的旅程将重塑我们与设备互动的方式。
嵌入式