


FPGA加速深度学习:速度、灵活性与能效的三重奏
FPGA加速深度学习:速度、灵活性与能效的三重奏
我最近出席硅谷2018 Xilinx开发者论坛,发现Mipsology,一家声称解决了在现场可编程门阵列(FPGA)部署神经网络相关AI挑战的初创公司。怀揣大胆愿景成立,Mipsology展示FPGA如何将任何神经网络加速至最高可能性能,不受传统部署约束束缚。
使用Xilinx新Alveo板卡,Mipsology在包括ResNet-50、Inception-V3、VGG-19在内的热门网络套件上实现超20,000张图像/秒。
何为神经网络与深度学习?
神经网络受人脑神经元网启发,构成深度学习(DL)脊柱。DL是数学框架,通过让网络暴露于海量数据自主学会执行任务。训练神经网络——呈现数百万标注样本——后随推理,训练模型对新数据预测结果。
例如,语音识别网络可能在数千语音录音上训练,后部署实时转录口语。
为何推理要求极致性能
推理每秒需数十亿或万亿次加法乘法——远超仅发生一次的训练。因此推理是生产AI系统计算需求主要驱动力。
深度学习推理四大硬件选项
工程师传统依赖四类处理器,按功耗从高到低、灵活性从低到高排序:CPU → GPU → FPGA → ASIC。下表总结关键差异。
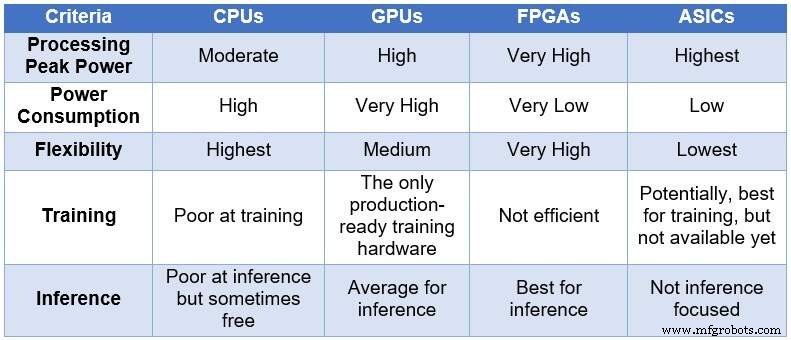
CPU、GPU、FPGA、ASIC用于DL计算对比(来源:Lauro Rizzatti)
- CPU提供最大灵活性但DL负载下高延迟低吞吐。
- GPU交付海量并行性但消耗显著功率并需强力散热。
- ASIC可针对窄任务极致高效,却因长开发周期和固定架构不适合快速演进模型。
- FPGA结合高吞吐、低功耗、可重构性,成动态推理负载理想平台。
FPGA为何在推理擅长
现代FPGA含数百万逻辑单元、数千DSP块、嵌入内存和ARM核心——全并行运行。单时钟周期可触发数百万并发操作,实现每秒万亿计算自然映射DL负载。
FPGA相对CPU/GPU关键优势含:
- 支持任意数据精度,允许低精度算术提升吞吐。
- 同等负载下功耗包络比同级CPU/GPU方案低5-10倍。
- 可重构性:同一设备可更新支持新模型无需流片新硅。
- 设备可扩展性:从高端数据中心卡到紧凑边缘模组,FPGA适配广泛部署场景。
挑战与权衡
尽管强项突出,FPGA呈陡峭学习曲线。开发高性能设计需专用硬件描述语言和深度并行理解,对习惯软件中心工作流团队构成障碍。
尽管如此,对要求速度、灵活性、能效三位一体的组织,FPGA代表当今深度学习推理最引人注目的平台。
物联网技术