


训练多层感知机:实现最优性能的经验策略
增加隐藏层节点能大幅提升感知机性能,但也使训练变得更复杂。
AAC神经网络系列至今,你已学习数据分类用神经网络,特别是感知机品类。
回顾系列或直接阅读本新条目,了解多层感知机(MLP)神经网络基础。
- 如何用神经网络分类:什么是感知机?
- 如何用简单感知机神经网络示例分类数据
- 如何训练基本感知机神经网络
- 理解简单神经网络训练
- 神经网络训练理论导论
- 理解神经网络学习率
- 多层感知机进阶机器学习
- Sigmoid激活函数:多层感知机激活
- 如何训练多层感知机神经网络
- 理解多层感知机训练公式与反向传播
- Python实现的神经网络架构
- 如何用Python创建多层感知机神经网络
- 神经网络信号处理:神经网络设计验证
- 神经网络训练数据集:如何训练验证Python神经网络
什么是多层感知机神经网络?
前文证明单层感知机无法产生现代神经网络架构期望的性能。局限于线性可分函数的系统无法逼近现实信号处理场景的复杂输入-输出关系。解决方案是多层感知机(MLP),如下:
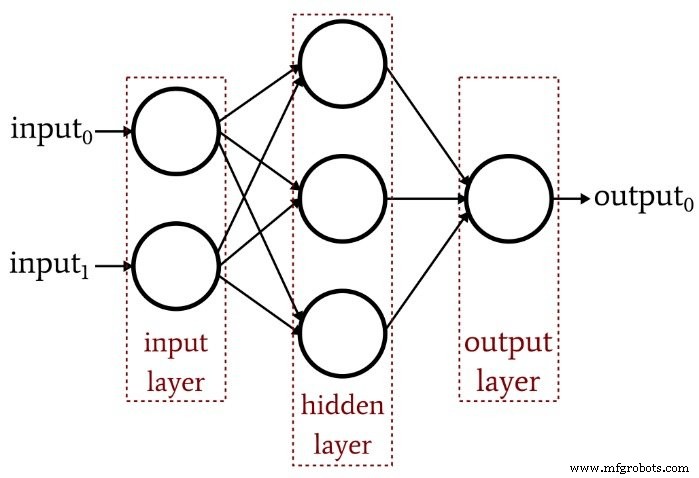
加入隐藏层将网络变为"通用逼近器",实现极其复杂的分类。但须牢记:神经网络价值完全取决于训练质量。无丰富多样训练数据和有效训练过程,网络永不会"学会"分类输入样本。
为何隐藏层使训练复杂化?
看之前文章训练单层感知机用的学习规则:
\[w_{new} = w+(\alpha\times(output_{expected}-output_{calculated})\times input)\]
注意方程隐含假设:基于观测输出更新权重,故单层感知机权重必须直接影响输出值。像用冷热水龙头旋钮调水温。整体温度与旋钮动作关系直观,甚至不喜欢数学的人也能摸索几分钟找到理想水温。
但现在想象冷热水管流量与旋钮位置呈复杂高度非线性关系。你缓慢稳定转热水旋钮,流量却反常波动。试冷水旋钮同理。在这些条件下达成理想水温——尤其"输出"须通过两个困惑控制关系组合——难得多。
这就是我理解的隐藏层困境。连接输入节点到隐藏节点的权重概念上类比那些机械反常旋钮——因输入-隐藏权重无直达输出层路径,这些权重与网络输出关系极复杂,上述简单学习规则将失效。
新训练范式
因原始感知机学习规则不适用多层网络,需重新思考训练策略。我们将引入梯度下降和误差函数最小化。
需记住:此训练过程不专用于多层神经网络。梯度下降源自通用优化理论,我们为MLP采用的训练过程也适用单层网络。但据我理解,MLP式梯度下降(至少理论上)对单层感知机非必需,因上述简单规则最终能搞定。
推导MLP实际权重更新方程涉及些许吓人数学,我不在此尝试智能解释。本文剩余目标:概念性介绍MLP训练两关键面——梯度下降和误差函数——下文将引入新激活函数继续讨论。
梯度下降
顾名思义,梯度下降基于斜率朝误差函数极小值下降。下图传达梯度如何给出修改权重信息——误差函数上一点斜率告诉我们朝哪方向走、离极小值多远。
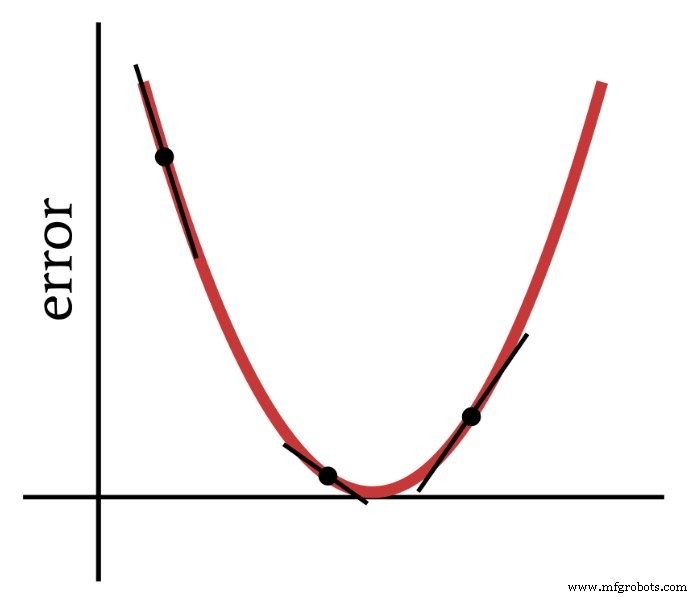
因此误差函数导数是训练多层感知机计算的重要元素。实际需偏导数。实施梯度下降时,每个权重修改量与误差函数关于被修改权重的斜率成比例。
误差函数(即损失函数)
量化神经网络误差常用法:对每输出节点,平方期望("目标")值与计算值之差,再求和所有平方差。可称"平方差和"或"平方误差和"或其他,也见LMS缩写,即least-mean-square,因训练目标是最小化均方误差。此误差函数(记E)数学表达如下:
\[E=\frac{1}{2}\sum_k(t_k-o_k)^2\]
其中k指示输出节点范围,t为目标输出值,o为计算输出值。
结论
我们为成功训练多层感知机奠定基础,下文将继续探索这个有趣话题。
工业机器人