


Python多层感知机添加偏置节点:方法与效果评估
本文解释如何在Python中将偏置节点纳入多层感知机(MLP),并评估其对分类性能的影响。
欢迎来到All About Circuits神经网络系列,由工程总监Robert Keim撰写。若未探索其他课程,下方列表提供坚实基础理解本文概念。
- 如何用神经网络分类:什么是感知机?
- 如何用简单感知机神经网络示例分类数据
- 如何训练基本感知机神经网络
- 理解简单神经网络训练
- 神经网络训练理论导论
- 理解神经网络学习率
- 多层感知机进阶机器学习
- Sigmoid激活函数:多层感知机激活
- 如何训练多层感知机神经网络
- 理解多层感知机训练公式与反向传播
- Python实现的神经网络架构
- 如何用Python创建多层感知机神经网络
- 神经网络信号处理:神经网络设计验证
- 神经网络训练数据集:如何训练验证Python神经网络
- 神经网络需要多少隐藏层和隐藏节点?
- 如何提高隐藏层神经网络准确率
- 将偏置节点纳入神经网络
偏置节点是提供常数值(通常+1)直接连接感知机输入或隐藏层的额外输入。它们允许网络在不改变输入数据情况下平移决策边界。本文展示两种添加偏置节点的实用方法并展示如何评估其对模型准确率的影响。
方法1:通过电子表格添加偏置
当训练或验证数据驻留电子表格时,可插入偏置列而不修改Python代码。
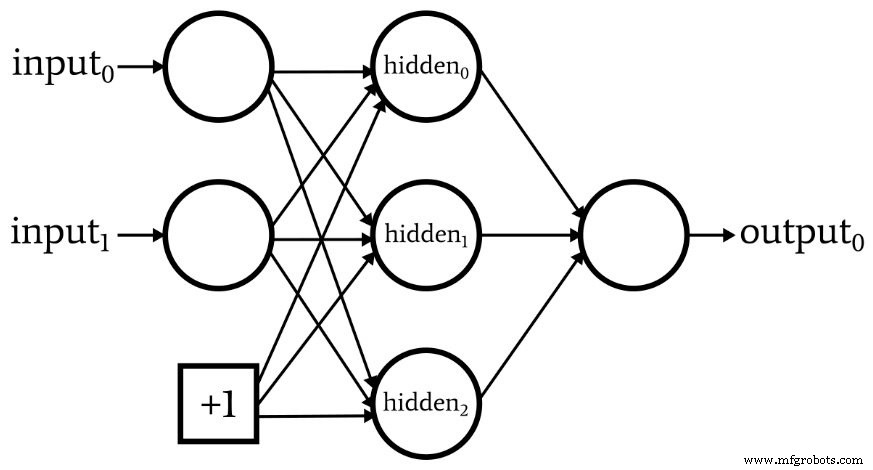
步骤:
- 在电子表格插入新列并填入期望偏置值(通常+1)
- 调整代码中输入层维度以适配新列
此法快速且无需代码修改,适合原型开发。
方法2:直接在Python中集成偏置
为更大灵活性——如向隐藏层添加偏置——需在代码中修改网络架构。下面简例在输入层和隐藏层均添加偏置节点。
更新输入层维度
# 加载训练数据
training_data = np.array(...)  # shape: (samples, features)
training_count = training_data.shape[0]
# 为输入偏置追加+1列
bias_column = np.ones((training_count, 1))
training_data = np.hstack((training_data, bias_column))
# 验证数据同理
validation_data = np.hstack((validation_data, np.ones((validation_count, 1))))此处np.ones创建全1列代表常数偏置输入。np.hstack将此列追加至现有特征矩阵。
添加隐藏层偏置节点
# 前向计算时
for node in range(hidden_dim):
    # 计算各隐藏节点加权和
    z = np.dot(input_vector, weights_input_hidden[:, node])
    post_activation[node] = activation_function(z)
# 在隐藏层末尾插入偏置节点值(+1)
post_activation[hidden_dim] = 1.0 # 末尾偏置节点当hidden_dim含偏置节点时,循环在最后一个节点前停止,随后赋值偏置。验证循环同理调整。
选择不同偏置值
虽+1为惯例,可尝试其他常数。输入偏置乘bias_column以期望值。隐藏偏置修改前向循环赋值语句。
评估偏置影响
系列第16部分MLP在高复杂度实验3数据集分类吃力。为测定偏置节点能否助益,我们对7单元隐藏层执行十次独立训练,对比四配置:无偏置、仅输入偏置、仅隐藏偏置、双偏置。
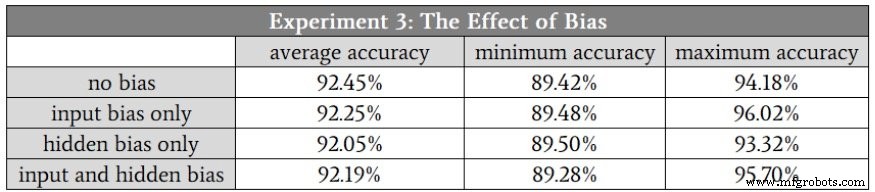
结果显示差异极小——偏置节点未显著提升此特定数据集准确率。此结果与其他研究一致:偏置节点在特定情境有益但非通用性能增强器。
结论
虽偏置节点鲜能在所有场景变革分类准确率,仍是宝贵架构工具。将偏置支持纳入代码库确保能快速测试其在未来数据集或模型变体上的有效性。遵循上述方法,可低成本添加偏置节点并系统评估其影响。
工业机器人