


深度解析 Hadoop:大数据处理核心框架指南
大数据时代的到来,使服务器面临前所未有的实时处理、排序、存储海量数据的挑战。Apache Hadoop 作为开源分布式计算框架,凭借高可靠、高扩展、高容错、低成本四大特性,成为大数据处理的基石级技术。
本文将系统介绍 Hadoop 核心组件、设计原理、生态工具、优势劣势及典型应用场景。
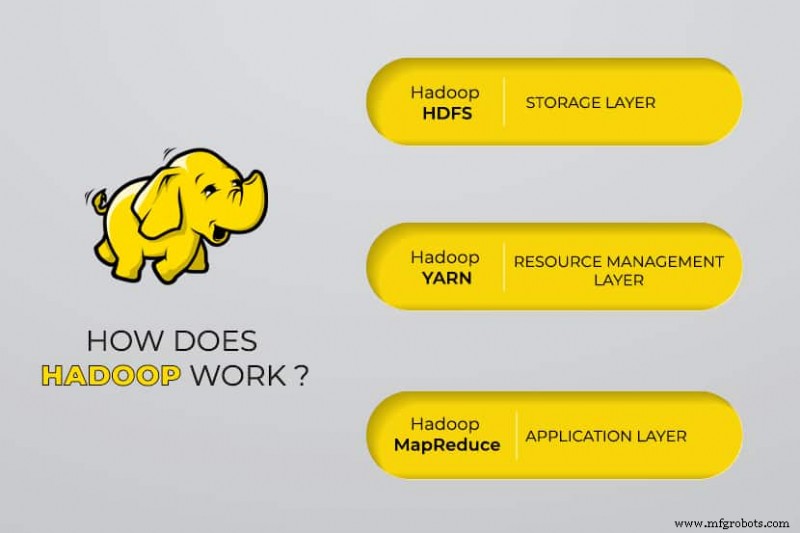
Hadoop 核心四大模块
Hadoop 分布式文件系统
HDFS 采用主从架构,将大文件切分为多个 Block(默认 128MB),按配置副本数(默认 3 副本)分散存储于集群 DataNode 上。NameNode 维护元数据(文件目录树、Block 位置映射),提供高吞吐率的流式数据访问,支持从单节点扩展至数万节点的商用硬件集群。
资源调度系统
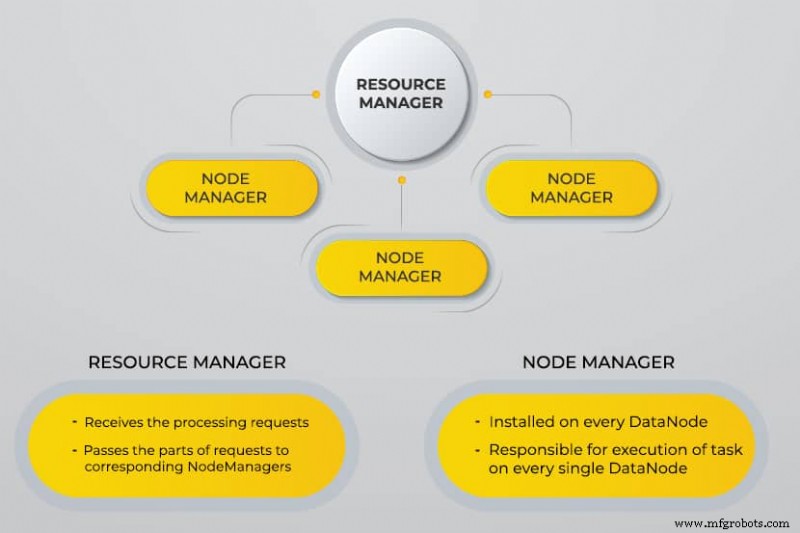
YARN 将资源管理与作业调度解耦。ResourceManager 全局调度资源,NodeManager 管理单节点资源,ApplicationMaster 负责单应用的任务切分与容器申请。支持 MapReduce、Spark、Flink 等多种计算框架共享集群资源。
MapReduce 计算模型
MapReduce 将计算分为 Map(映射)与 Reduce(归约)两阶段。Map 任务并行处理输入数据生成键值对,经 Shuffle 排序分组后交给 Reduce 任务聚合输出结果。适合批处理、ETL、离线分析等高吞吐、非实时场景。
Hadoop Common 基础库
提供各模块共用的 Java 工具类,如配置解析、序列化、RPC、文件系统抽象接口等,保障跨模块兼容性。
Hadoop 诞生背景:解决海量网页索引难题
万维网爆发式增长导致两大核心痛点:
- 海量非结构化数据难以高效存储与检索
- 单机计算能力无法满足大规模数据处理需求
Google 发布 GFS、MapReduce、Bigtable 三篇奠基论文,Doug Cutting 等人在 Nutch 项目基础上开源实现,演化为 Hadoop,大幅降低了分布式存储计算的门槛与成本。
Hadoop 大数据处理工作流
1. 客户端通过 API 向 NameNode 申请写入,获取 Block 分配与 DataNode 列表
2. 客户端以 Pipeline 方式并行写入多个 DataNode 副本
3. NameNode 记录 Block 位置元数据,定期接收 DataNode 心跳与 Block 报告
4. 计算作业提交至 YARN,ApplicationMaster 向 RM 申请 Container 资源
5. MapTask 就近读取本地/机架本地 Block 数据,输出中间键值对
6. Shuffle 阶段分区、排序、溢写、归并,ReduceTask 拉取数据聚合计算
7. 最终结果写回 HDFS 或外部存储
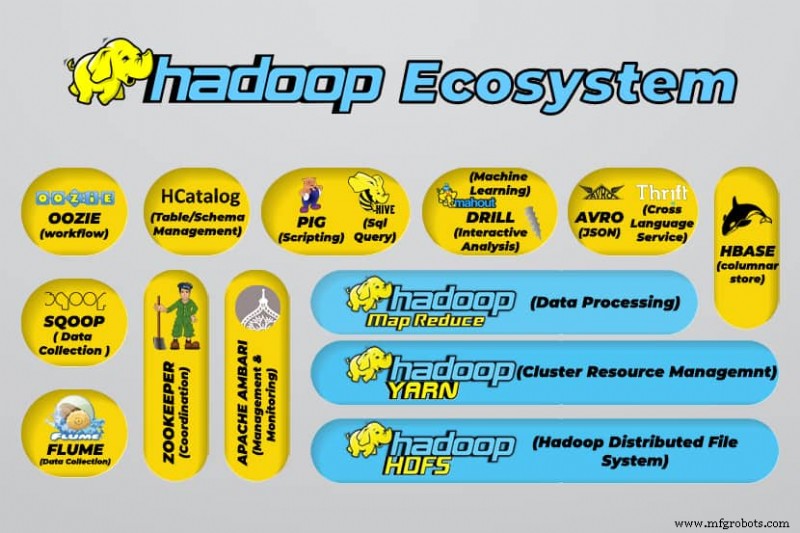
Hadoop 生态核心工具矩阵
| 工具 | 定位 | 核心能力 |
|---|---|---|
| Hive | 数仓 SQL 引擎 | 将 SQL 编译为 MapReduce/Tez/Spark 作业,支持海量数据离线分析 |
| ZooKeeper | 分布式协调服务 | NameNode HA 自动故障转移、配置管理、分布式锁 |
| HBase | 宽表 NoSQL 数据库 | 亿级行、百万列稀疏表,毫秒级随机读写,适合实时查询 |
| Flume | 日志采集传输 | 分布式、高可靠、可定制的海量日志聚合管道 |
| Sqoop | 关系型数据库同步 | 基于 JDBC 并行导入导出,支持全量/增量同步 |
| Pig | 数据流脚本语言 | Pig Latin 简化复杂 ETL 逻辑,自动优化执行计划 |
| Oozie | 工作流调度 | 基于 DAG 定义作业依赖,支持定时/事件触发 |
| HCatalog | 元数据统一视图 | 跨引擎共享表结构与分区信息,消除数据孤岛 |
Hadoop 六大核心优势
- 高吞吐存算一体:数据本地化计算,移动计算而非移动数据,PB 级数据小时级处理
- Schema-on-Read 灵活建模:写入时不定 Schema,读取时动态解析,原生支持文本、图片、视频、日志等非结构化数据
- 商用硬件低成本:X86 通用服务器组建集群,无需昂贵小型机/存储阵列,开源免费无授权费
- 线性水平扩展:新增节点自动加入集群,数据自动再平衡,无需停机迁移
- 软件层高可用:多副本冗余+自动故障转移,硬件故障对上层透明,99.99%+ 可用性
- 成熟生态兼容性:主流 BI、AI、流计算框架均对接 HDFS/YARN,避免厂商锁定
三大经典应用场景
PB 级海量离线分析
适用于日志全量分析、用户行为画像、风控模型训练、基因测序等计算密集、容错要求高、延迟不敏感的批处理作业。百 GB 以下数据集建议直接用数仓/数据库,投入产出比更高。
多模态数据湖建设
HDFS 低成本存储结构化/半结构化/非结构化原始数据,配合 Hive/Impala/Presto 多引擎查询,支撑“一次采集、多次计算、灵活探索”的数据湖架构。
大规模并行 ETL 与特征工程
MapReduce/Spark 在 HDFS 上并行执行数据清洗、去重、聚合、特征抽取,输出喂给下游机器学习平台。注意:迭代式算法(如 PageRank、协同过滤)在原生 MapReduce 上性能差,建议迁移至 Spark/GraphX。
真实落地案例
- 客户洞察与精准营销:金融/电商/社交巨头分析点击流、交易、社交图谱,实现千人千面推荐与实时风控
- 业务流程优化:制造业利用传感器数据预测性维护,零售业优化库存周转与补货策略
- 医疗健康研究:电子病历、基因组、影像数据联合分析,辅助疾病预测与新药研发
- 高频量化交易:毫秒级行情解码、因子计算、信号生成、风控拦截全链路加速
- 物联网时序数据中台:亿级设备上报数据汇聚、清洗、下发指令,支撑智慧城市/工业互联网平台
Hadoop 面临的挑战与演进方向
- MapReduce 迭代计算短板:中间结果落盘开销大,已被 Spark 内存计算、Flink 流批一体架构替代
- 元数据管理薄弱:原生缺乏数据血缘、质量、治理工具,需引入 Atlas/Amundsen 等数据治理平台
- 人才门槛高:Java/Scala 开发、内核调优、故障排查需深厚功底,SQL 化(Hive/Spark SQL)降低门槛成趋势
- 安全体系建设:Kerberos 认证、Ranger 权限、加密传输/存储、审计日志需体系化部署
总结
Hadoop 以“移动计算就近数据”思想重塑了大数据基础设施,虽核心计算引擎逐渐让位于 Spark/Flink,但 HDFS/YARN 仍是数据湖存算分离架构的基石。云原生时代,Hadoop 向容器化(Kubernetes 上运行 YARN)、存算分离(对象存储替代 HDFS)、Serverless 化演进,持续服务于海量数据资产的沉淀与价值挖掘。
云计算