


C 语言联合体实现高效数据打包与解包详解
C 语言联合体实现高效数据打包与解包
联合体提供了一种强大且内存高效的方式,将同一字节序列重新解释为不同数据类型。虽最初设计用于互斥变量共享内存,现代 C 程序员常用联合体进行数据打包、解包和类型双关——特别是处理串行协议或底层通信时。
联合体如何共享内存
联合体所有成员共享同一内存区域。最大成员决定联合体大小,每个成员起始地址相同。
union { uint16_t word; struct { uint8_t byte1; uint8_t byte2; }; } u1;此处 word 占两字节,嵌套结构将这两字节拆分为 byte1 和 byte2。内存布局可视化为:
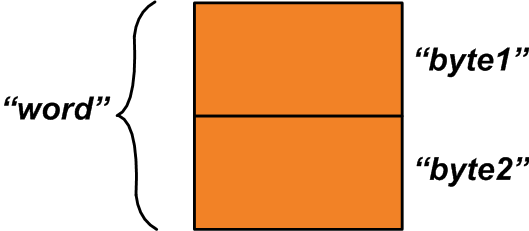
将两字节打包为 16 位字
要将两个 8 位值 x 和 y 合并为 16 位字,赋值给结构成员再读取 word 成员:
u1.byte1 = y; u1.byte2 = x; uint16_t packed = u1.word;这种“数据双关”直观但依赖处理器字节序。
处理器字节序的影响
小端系统先存储最低有效字节,大端系统先存储最高有效字节。以序列 0x01020304 为例:
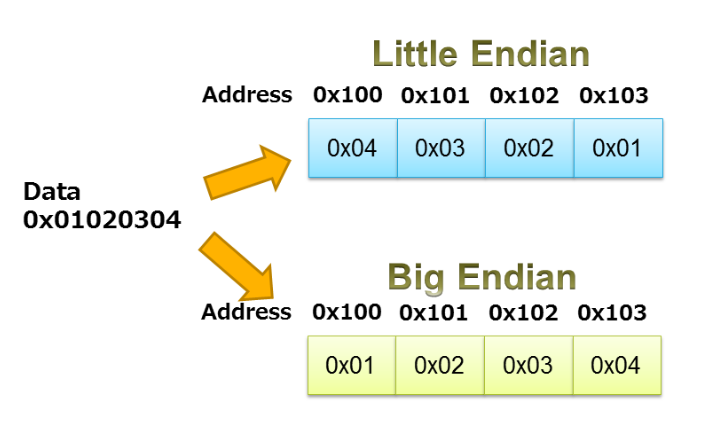
在小端机器运行简单测试:
#include <stdio.h> #include <stdint.h> int main() { union { struct { uint8_t byte1; uint8_t byte2; }; uint16_t word; } u1; u1.byte1 = 0x21; u1.byte2 = 0x43; printf("Word is: %#X\n", u1.word); return 0; }输出:Word is: 0X4321——确认小端存储。大端目标相同代码输出 0X2143。
位运算替代方案:与字节序无关的打包
移位和掩码提供跨架构可移植的 16 位值构建方式:
uint16_t word2 = (((uint16_t)byte3) << 8) | ((uint16_t)byte4);对比两种方法:
#include <stdio.h> #include <stdint.h> int main() { union { struct { uint8_t byte1; uint8_t byte2; }; uint16_t word1; } u1; u1.byte1 = 0x21; u1.byte2 = 0x43; printf("Word1 is: %#X\n", u1.word1); uint8_t byte3 = 0x21, byte4 = 0x43; uint16_t word2 = (((uint16_t)byte3) << 8) | ((uint16_t)byte4); printf("Word2 is: %#X\n", word2); return 0; }大端处理器:Word1 is: 0X2143,Word2 is: 0X2143。小端处理器:Word1 is: 0X4321,Word2 is: 0X2143。位运算方法保证跨架构结果一致。
实战示例:通过 UART 发送浮点数
串行链路通常逐字节传输。发送 32 位 float 可用联合体将其视为四字节数组:
union buffer { float f; struct { uint8_t byte[4]; }; };发送端:
union buffer tx; union buffer rx; float f1 = 5.5f; tx.f = f1; for (int i = 0; i < 4; ++i) { // send tx.byte[i] over UART rx.byte[i] = tx.byte[i]; // 模拟接收 } printf("The received data is: %f\n", rx.f); 输出:The received data is: 5.500000。联合体清晰分离字节表示与浮点值,代码可读性强且易维护。
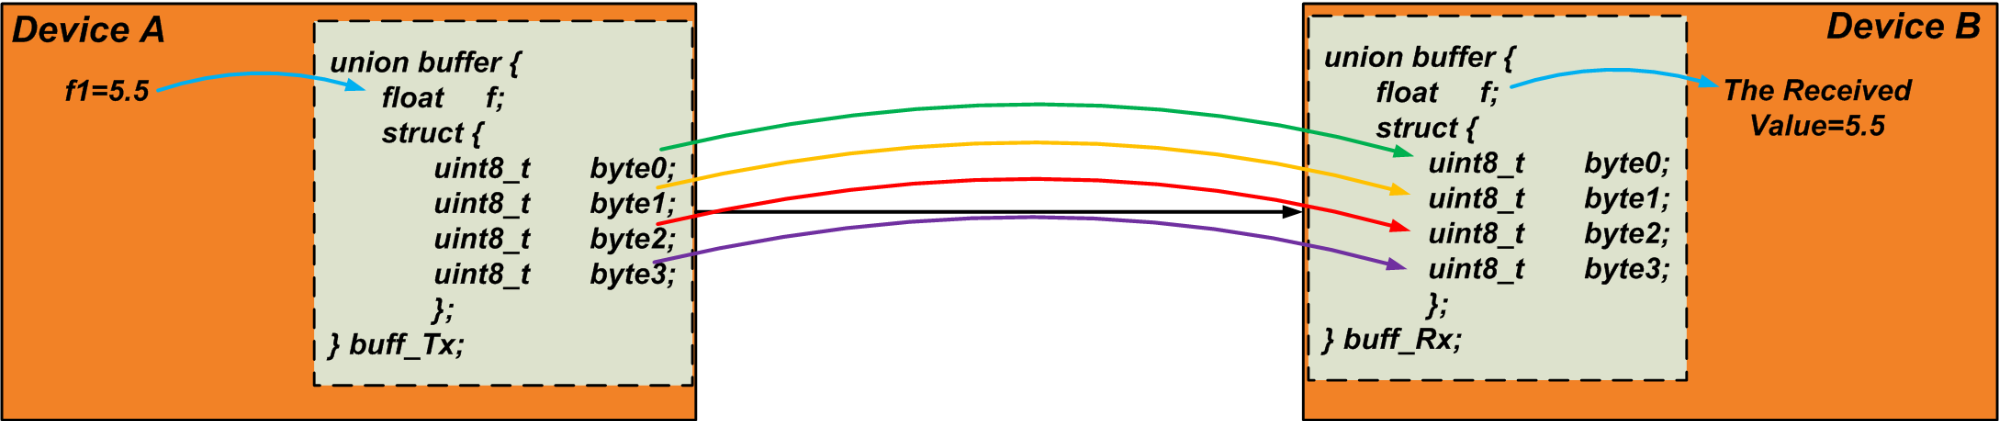
核心要点
- 联合体支持类型双关,但结果依赖字节序。
- 位运算符提供可移植、架构无关的打包方式。
- 为清晰和维护,许多嵌入式开发者仍偏好联合体。
- 联合体在通过面向字节的链路传输任意数据结构时大放异彩。
探索更多 C 语言、联合体和嵌入式系统内容,浏览完整文章列表。
嵌入式