


如何调试基于Zephyr的物联网设备:经验证的远程监控实践
Linux基金会Zephyr开源项目已成为无数物联网解决方案基石。凭借为资源受限设备设计的轻量、可扩展、实时操作系统(RTOS),Zephyr支持广泛架构——ARC、Arm、Intel、Nios、RISC-V、SPARC、Tensilica——及250多块开发板。如今项目拥有1000贡献者、5万次提交,持续扩展多架构覆盖。
为Zephyr开发要求关注可靠性。实验室出现的问题往往仅在设备规模化或网络栈演进时显现。强大的远程监控和调试策略至关重要,可在问题转化为昂贵停机前检测、诊断、解决。
以我们为农场动物监测开发GPS追踪器为例。每个项圈必须跨多蜂窝网络、国家、漫游区无缝运行。因配置错误导致的意外耗电将转化为重大经济损失。我们不仅需要标记问题,更需理解根因并部署修复——因此需要实时远程可观测性。
我们将Zephyr与Memfault(基于云的设备可观测性平台)结合,构建涵盖固件更新、重启、看门狗、故障、断言、连接指标的监控栈。
搭建可观测性平台
Memfault赋能开发者远程监控、调试、推出固件变更,实现:
- 避免冻结的优雅生产发布
- 设备群持续健康监控
- 用户察觉前零停机补丁交付
将Memfault SDK集成至Zephyr很简单:在west.yml清单添加模块,在prj.conf启用。
# west.yml [ ... ] - name: memfault-firmware-sdk url: https://github.com/memfault/memfault-firmware-sdk path: modules/memfault-firmware-sdk revision: master # prj.conf CONFIG_MEMFAULT=y CONFIG_MEMFAULT_HTTP_ENABLE=y1️⃣ 关注重启
重启率上升常是深层问题首个信号——硬件退化、固件Bug、网络异常。通过区分硬件和软件重启,可定位故障是普遍还是隔离于设备子集。
重启前记录原因
void fw_update_finish(void) { // … memfault_reboot_tracking_mark_reset_imminent(kMfltRebootReason_FirmwareUpdate, ...); sys_reboot(0); }Zephyr在复位间保留用户定义区域;Memfault挂钩捕获重启上下文。重启后,注册初始化处理程序读取硬件复位原因并发送至云端。
static int record_reboot_reason(void) { // 1. 读取硬件复位原因寄存器(参考MCU数据手册) // 2. 从noinit RAM捕获软件复位原因 // 3. 发送数据至服务器聚合 } SYS_INIT(record_reboot_reason, APPLICATION, CONFIG_KERNEL_INIT_PRIORITY_DEFAULT);示例:电源缺陷可表现为短期内数千次重启。图1显示某车队每天12,000次重启中99%归因于仅十台设备——可能是机械或电池问题。固件更新可缓解此类问题,但远程监控让你在级联前检测并解决。
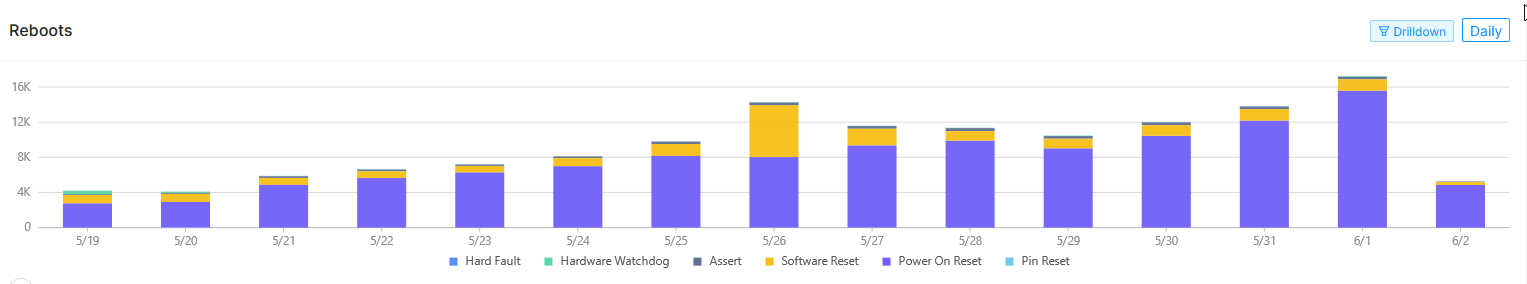
图1:电源问题,15天重启统计。(来源:作者)
- 每天12K设备重启 – 过多
- 99%重启来自10设备
- 机械缺陷导致持续复位
2️⃣ 利用看门狗
看门狗是防卡死最后防线——无论由阻塞网络栈、无限循环、死锁、内存损坏引起。Zephyr暴露统一看门狗API抽象硬件差异。
void start_watchdog(void) { struct device *s_wdt = device_get_binding(DT_LABEL(DT_INST(0, nordic_nrf_watchdog))); struct wdt_timeout_cfg wdt_config = { .flags = WDT_FLAG_RESET_SOC, .window.min = 0U, .window.max = WDT_MAX_WINDOW, }; s_wdt_channel_id = wdt_install_timeout(s_wdt, &wdt_config); const uint8_t options = WDT_OPT_PAUSE_HALTED_BY_DBG; wdt_setup(s_wdt, options); } void feed_watchdog(void) { wdt_feed(s_wdt, s_wdt_channel_id); }对于Nordic nRF9160,典型工作流:
- 为看门狗配置设备树。
- 通过API设置参数。
- 安装看门狗。
- 定期喂狗;错过喂狗触发重启和Zephyr故障处理程序。
Memfault捕获复位前状态,允许追溯到致故障代码路径。示例:部署16个月后SPI驱动卡死由看门狗触发故障揭示。图2展示时间线和退化,图3显示故障处理程序寄存器转储。
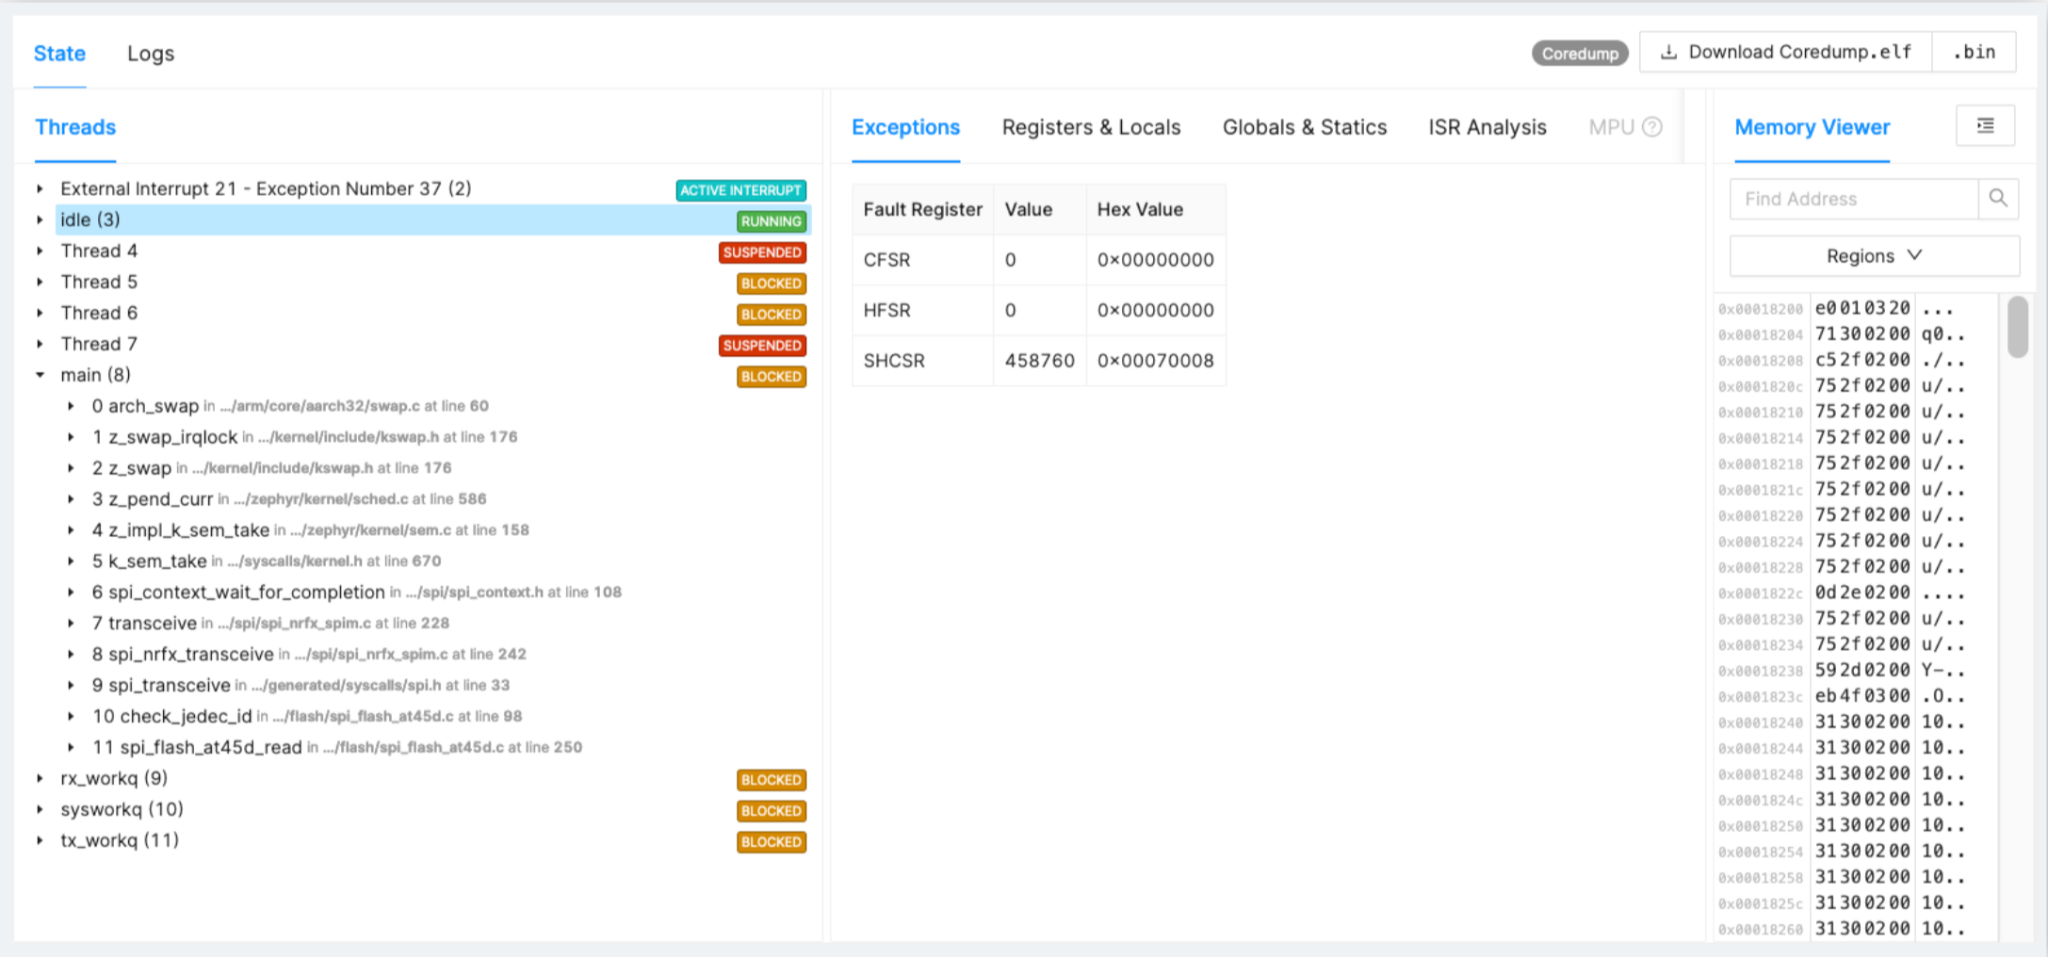
图2:SPI驱动卡死示例。(来源:作者)
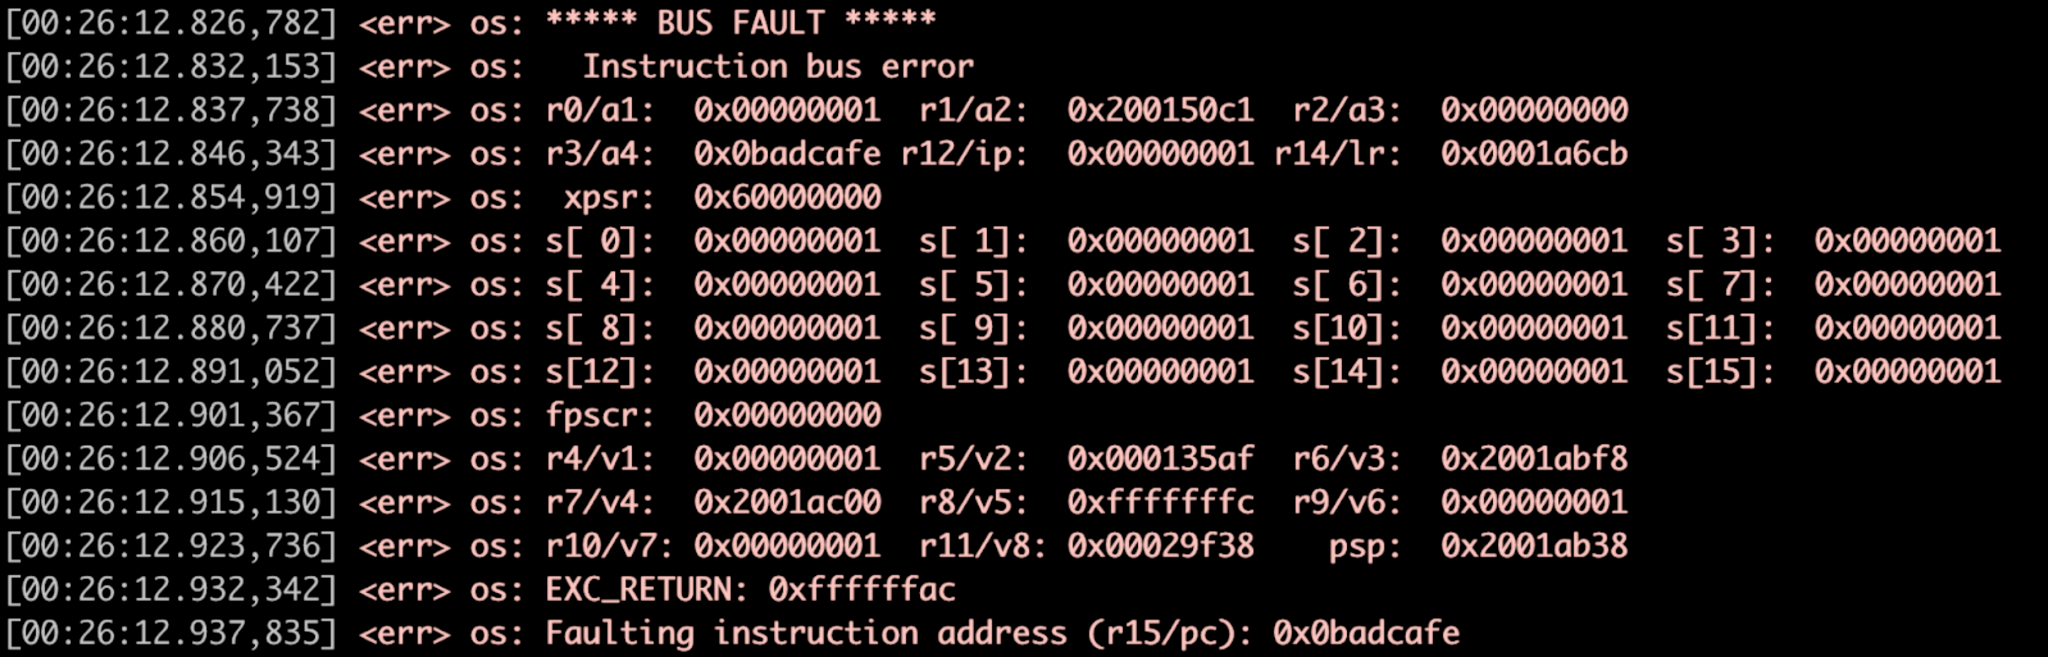
图3:故障处理程序示例,寄存器转储。(来源:作者)
3️⃣ 处理故障与断言
当断言或故障触发,Zephyr故障处理程序捕获CPU状态。Memfault无缝挂钩此流程,将寄存器、内核上下文、所有活动任务快照持久化至云端。
void network_send(void) { const size_t packet_size = 1500; void *buffer = z_malloc(packet_size); // 缺失NULL检查导致故障 memcpy(buffer, 0x0, packet_size); } bool memfault_coredump_save(const sMemfaultCoredumpSaveInfo *save_info) { // 存储寄存器状态、内核与任务上下文、选定.bss/.data } void sys_arch_reboot(int type) { // … }关键诊断包括:
- Cortex-M故障状态寄存器指示原因。
- Memfault还原确切代码行及周围任务状态。
_kernel结构揭示调度器状态,对连接栈显示蓝牙或LTE参数。
4️⃣ 跟踪设备级指标
指标提供车队健康可量化视图。常监控值包括CPU负载、连接指标、热力数据。Memfault SDK让你用极少代码声明报告指标。
- 定义指标
MEMFAULT_METRICS_KEY_DEFINE( LteDisconnect, kMemfaultMetricType_Unsigned)- 代码中更新
void lte_disconnect(void) { memfault_metrics_heartbeat_add( MEMFAULT_METRICS_KEY(LteDisconnect), 1); // … }Memfault云后端按设备和固件版本聚合指标,提供Web UI对比车队和触发告警。典型用例:
- NB-IoT/LTE-M连接:监控调制解调器电源状态评估电池影响。
- 基站事件和PSM时序:识别耗电的信号质量热点。
- 大规模车队遥测:发现异常值和意外数据峰值。
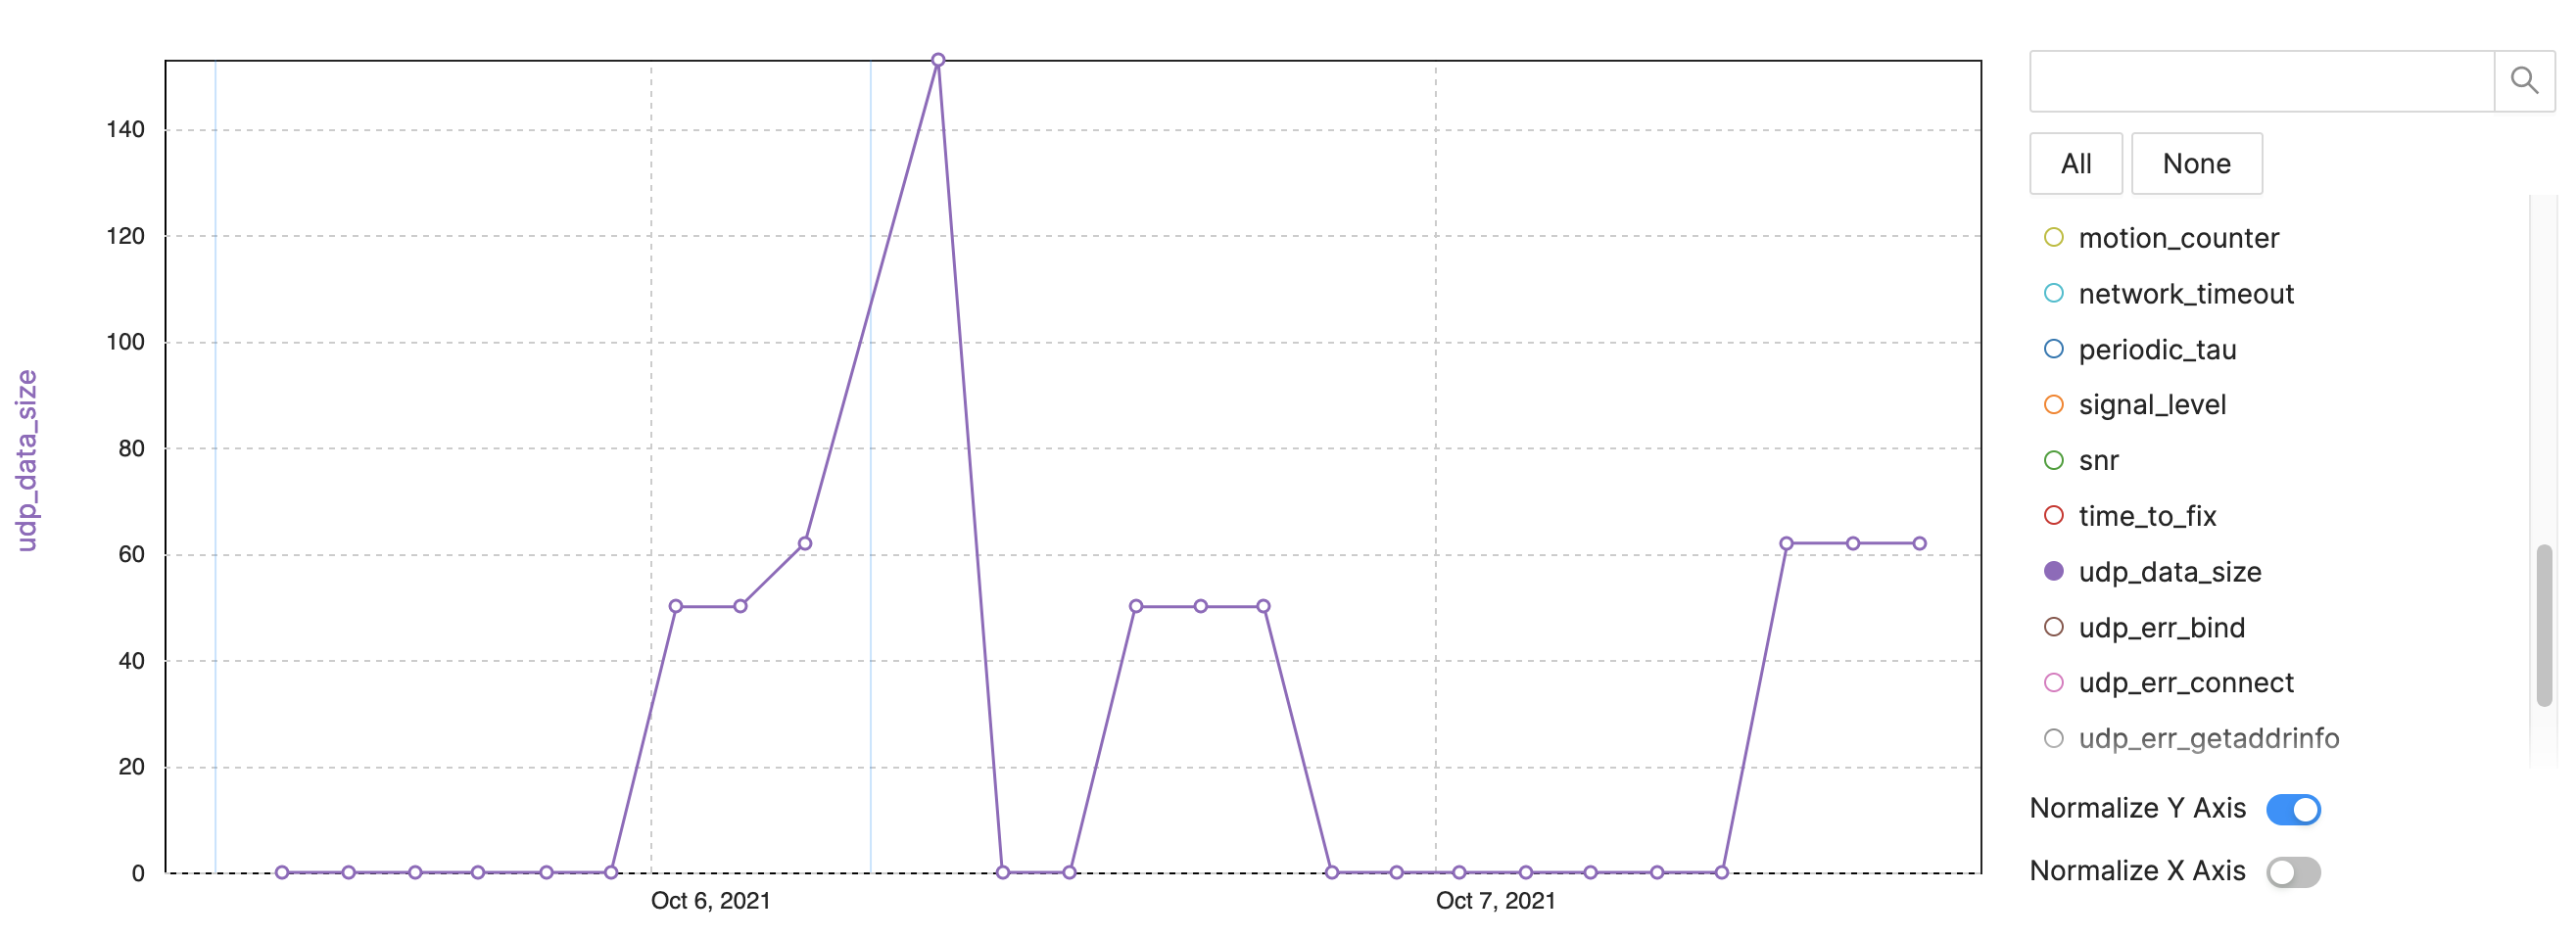
图4:设备可观测性指标追踪 – NB-IoT示例,LTE-M数据大小。(来源:作者)
- 每发送间隔UDP数据大小。
- 重启后数据激增。
- 大包指示嵌入式追踪或诊断。
- 用指标控制数据用量和成本。
结论
集成Zephyr与Memfault,开发者获得强大端到端可观测性栈。聚焦四大支柱——重启、看门狗、故障/断言、连接指标——将设备群从不透明黑盒转为透明、可管理系统。深入洞察请观看2021 Zephyr开发者峰会录制演讲。
物联网技术