


数据科学揭秘:核心概念、类型划分与职业机遇全景图
什么是数据科学?
数据科学是一门跨学科领域,运用科学方法、流程与系统,采集、清洗、分析结构化与非结构化数据。它融合数学、统计学、数据库、信息科学与计算机科学等多个学科。数据类型多样、规模各异。
为何数据科学成为独立学科?
核心驱动力是数据的指数级爆发。预估2020年每秒产生1.7MB数据,数字数据总量将达44万亿GB。面对海量数据,理解与存储愈发困难,亟需系统化研究手段——数据科学应运而生。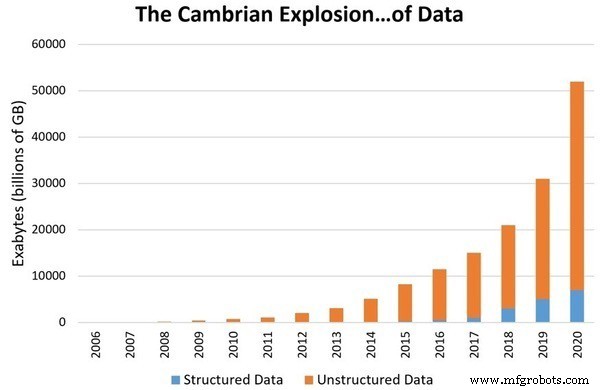
数据科学在身边的应用
企业利用数据科学优化内部数据流程。Google通过AdSense个性化广告投放;Uber动态计价与精准发券;Airbnb辅助房东定价。简而言之,将客户/用户视为原始数据,数据科学负责解读与变现。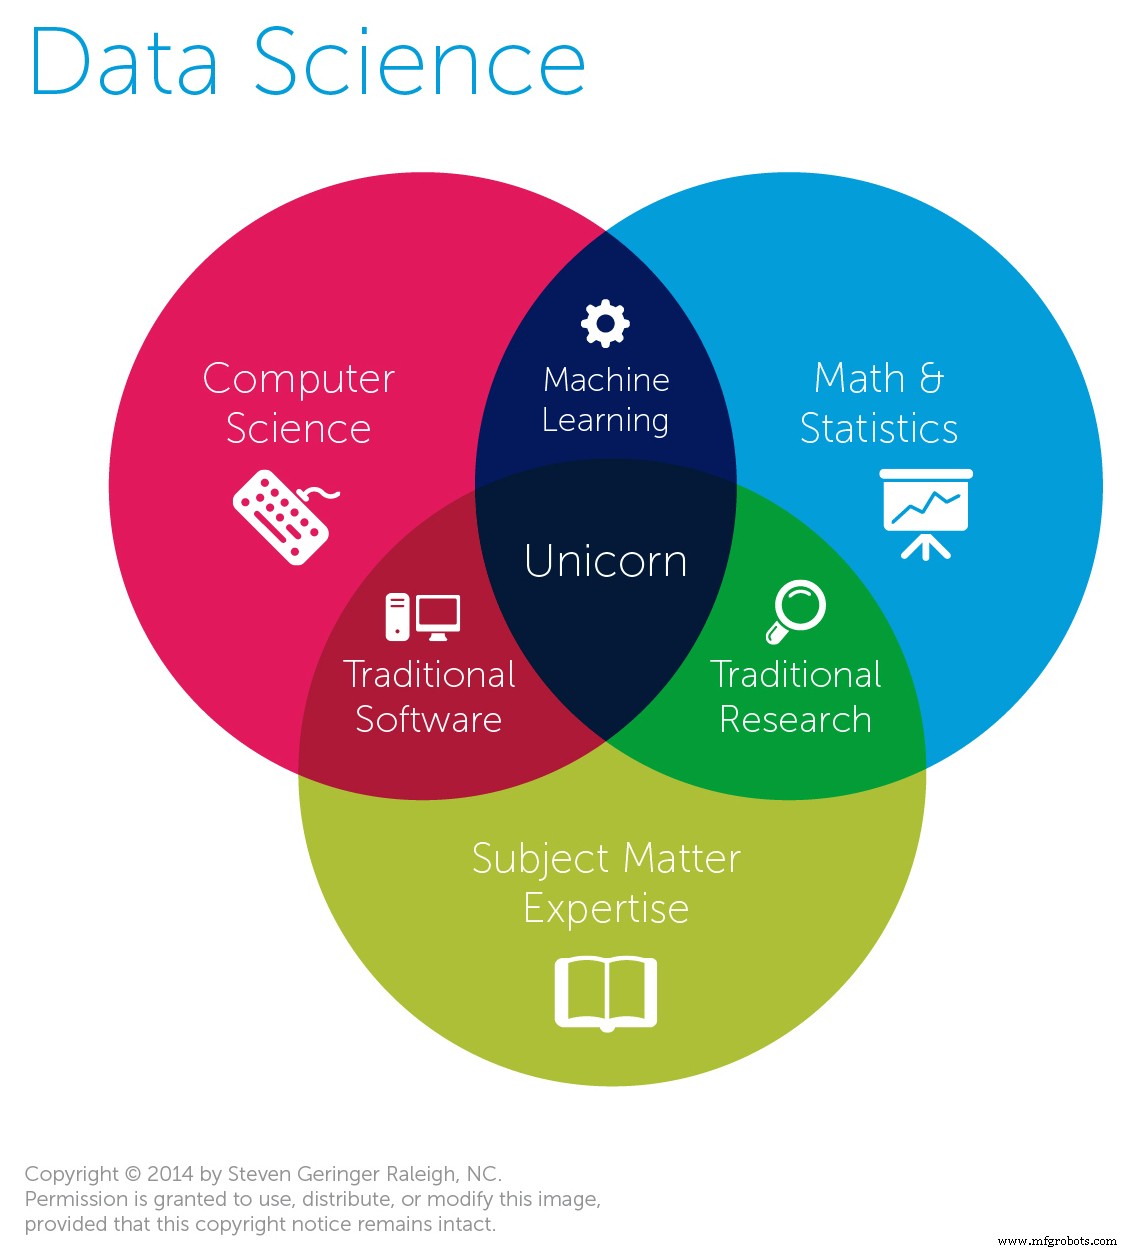
政府与非政府组织中的数据科学
数据是政府核心资产,每日增量巨大,数据科学提供分类存储方案。WWF等非政府组织利用数据科学以统计可视化呈现野生动物议题,强化倡导效力。
数据科学职业机遇
领域持续扩张,岗位需求指数级增长。LinkedIn分析显示过去30年数据科学岗位大幅增加。有志者可通过在线免费课程入门,推荐Commonlounge教程。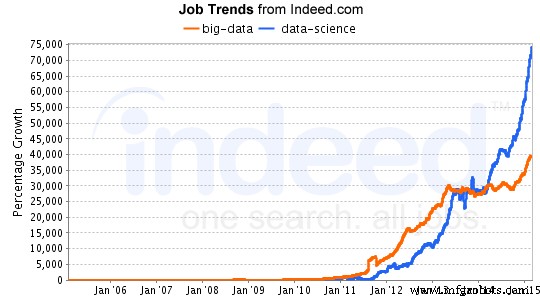
核心组件详解
1. 编程语言
数据处理离不开编程。主流语言为Python与R。
- Python:可读性强、灵活易学,拥有NumPy、pandas、Matplotlib、TensorFlow、iPython等强大统计/数值计算库,执行效率高。
- R:侧重统计建模与图形技术,统计学家与数据挖掘师广泛使用,开源免费。
2. 数据及其类型
- 结构化数据:高度组织化,可用表格表示,便于数据库存储处理。
- 非结构化数据:无预定义模型,含文本、日期、数字、邮件、PDF、图像、视频等。
- 自然语言:书面交流语言(英语、西班牙语、乌尔都语等),可视为非结构化子类。
- 图像、视频、音频:智能手机普及下日增海量,非结构化形式。
- 图数据:顶点与边集合,用于展示实体间关系的数学结构。
- 机器生成数据:计算机系统/应用/机器自动产出,无人工介入。
3. 统计学、概率论与数据科学的关系
- 统计学:数学分支,涵盖数据收集、解释、分析、呈现与组织,借助编程分析数据。
- 概率论:衡量事件发生可能性,量化为0-1区间数值(0不可能,1确定)。
- 关联性:两者是数据处理与分析的基石,配合数据科学实现正确解读。
4. 机器学习
源自AI的计算机科学分支,利用统计技术让计算机在无显式编程下学习。核心目标三点:学习变化表征、泛化性能、提升性能并防退化。数据科学中用于算法、回归、分类及预测建模。
5. 大数据
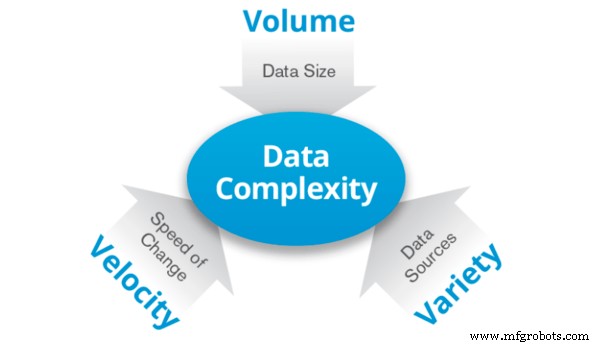
指存储处理需大规模计算集群的海量数据,具备三大V特征:
- Volume(体量):TB到ZB级
- Variety(多样性):多类型混合(结构化+非结构化)
- Velocity(速度):持续高速生成
数据科学家使用Hadoop、Spark、R、Java等工具处理大数据。传统应用无法胜任大规模数据处理。
工业技术