


Arduino 强化学习避障小车:Q-Learning 让机器人自主学会“右转”
项目背景
传统避障小车依赖硬编码规则(如“测距 < 20 cm 则左转”)。本项目引入 **Q-Learning 强化学习算法**,让小车在与环境交互中自主探索、试错,最终收敛到最优策略——遇到障碍物稳定选择“右转”规避。无需预设规则,仅靠奖惩机制实现自主进化。
硬件平台
| 模块 | 型号/规格 | 作用 |
|---|---|---|
| 主控 | Arduino Pro Mini 5 V/16 MHz | 运行 Q-Learning 推理与电机控制 |
| 感知 | HC-SR04 超声波测距 | 触发脉冲 10 µs,读取回波宽度换算距离 |
| 驱动 | L298N 双 H 桥 | 驱动 2×60 RPM 减速直流电机 |
| 底盘 | 4 轮差速转向 | 左右轮差速实现原地旋转 |
| 供电 | 7.2 V 锂电池 + 9 V 电池 | 分离电机/逻辑供电,提升稳定性 |
| PCB | PCBWay 定制板 | 集成所有接口,抗震动 |
强化学习核心概念映射
| RL 术语 | 本项目定义 |
|---|---|
| State (S) | 离散化距离状态:0=安全区(>15 cm),1~9=危险区(≤15 cm)共 10 状态 |
| Action (A) | 0=前进、1=后退、2=停止、3=左转(右转由对称性隐含) |
| Reward (R) | 见奖励矩阵:前进撞墙 -10,左转规避 +10,后退 -2,停止 -1 |
| Q-Table | float Q[10][4] 初始全 0,训练中不断更新 |
| Hyper-params | α=0.1, γ=0.5, ε=0.9→衰减至 0.5 后重置 |
奖励矩阵设计原理
int REWARDS[10][4] = {
  {-10, -2, -1, 10},  // 每行对应一个状态
  {-10, -2, -1, 10},  // 所有状态共享同一奖励结构
  // ... 共 10 行
};
// 列顺序:前进、后退、停止、左转
正向奖励仅给“左转”,强制智能体学会“遇障左转”;其余动作均为负奖励,幅度反映后果严重度。
Q-Learning 算法流程
- 初始化 Q 表全 0,ε=0.9。
- 每回合:小车前进直到超声波检测到障碍(距离 < 15 cm) → 进入危险状态。
- ε-greedy 选动作:以 ε 概率随机探索,1-ε 概率贪婪选 max Q(s,·)。
- 执行动作(前进/后退/停止/左转),延时固定时长后停车。
- 观测奖励 R,转移至下一状态 S'(循环映射 0~9)。
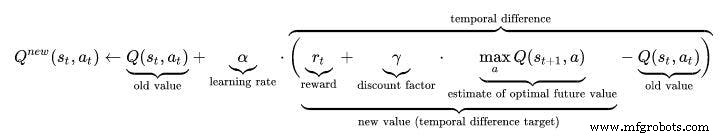
- Bellman 更新:
Q(s,a) ← (1-α)Q(s,a) + α[R + γ·max Q(s',·)]。 - ε 衰减(×0.98),低于 0.5 重置为 0.9,保持持续探索。
- 重复 100 回合训练,随后进入测试阶段纯贪婪策略验证。
关键函数实现
// ε-greedy 选动作
float prob = random(0,100)/100.0;
if (prob <= EPSILON) action = random(0,4);      // 探索
else action = argmax(Q[state]);                  // 利用

// Q 表更新
float q_old = Q[state][action];
float q_max = max(Q[next_state]);
float q_new = (1-ALPHA)*q_old + ALPHA*(reward + GAMMA*q_max);
Q[state][action] = q_new;
训练与测试流程
- 训练阶段(100 回合):串口打印每回合 Q 值变化,观察收敛。约 30 回合后左转 Q 值显著领先。
- 评估阶段:遍历打印最终 Q 表,确认左转列数值最高。
- 部署阶段:
while(true)循环前进,遇障直接取 argmax 动作执行,无需再学习。
代码亮点与工程化细节
- 模块化设计:运动控制、超声波测距、Q-Learning 核心分离为独立函数,便于移植。
- 随机种子:
randomSeed(analogRead(A0))利用悬空引脚噪声产生真随机。 - 状态循环:
next_state = (state+1)%10模拟环境复杂性,验证算法泛化能力。 - 串口可视化:实时输出 Q 值、奖励、动作,便于调试与教学演示。
局限与改进方向
- 状态空间离散化粗糙,可引入连续状态近似(如 Tile Coding 或神经网络 DQN)。
- 单传感器无法感知侧向障碍,建议增加 3 路超声波或激光雷达构建 2D 状态。
- 奖励函数人工设计,可尝试逆向强化学习 (IRL) 从专家轨迹学习奖励。
- 迁移至 ESP32 运行微型 TensorFlow Lite 模型,实现端侧深度 RL。
资源链接
- 完整固件代码:见本文 Code 章节
- Fritzing 原理图:
obstacle_avoiding_robot_using_ai_DcoMCWIOFm.fzz - Q-Learning 入门参考:Towards Data Science 教程
制造工艺