


规模化AI赢取实战业务增益:运营成功的实证策略
人工智能(AI)正驱动跨行业企业的新常态。零售商可用AI基于历史库存数据预测采购订单驱动智能补货决策。客服团队可用AI自动响应并路由高优先级工单至正确团队。用AI、特别是ML驱动实际业务成果的可能性广阔无垠。
据Deloitte Insights,83%企业AI早期采用者从生产项目中获正ROI。包括:使用AI的第三方企业软件实施、聊天机器人与虚拟助手、电商推荐引擎。83%受访企业计划2019年增加AI支出。投资AI的企业中,63%已采用ML。
构建务实用AI与ML达成业务目标的策略是许多企业首要任务。对许多人,成功运营化ML的主挑战是理解、规划、执行跨组织的全息ML部署管理。
运营化ML的关键考量
"正确"应对数据科学生命周期因组织而异。许多尝试编纂标准化数据科学生命周期程序。但无单一方法融合每个企业需求。
拥抱可持续可维护的数据与数据科学策略是独特于各企业的持续演进练习。因每公司需求、架构、能力独特,必须咨询跨企业利益相关者构建灵活可扩展ML模型、执行全息数据科学策略。
各企业必须解决的运营挑战与基础设施开发实践变更将不同。
关键在于:组织在定义演进数据科学生命周期时,必须考量自身文化、系统、需求。跨团队呈现基础框架有助于在持续开发演进ML运营化时建立共同沟通基础。
让我们走过助组织开启ML旅程的标准框架。
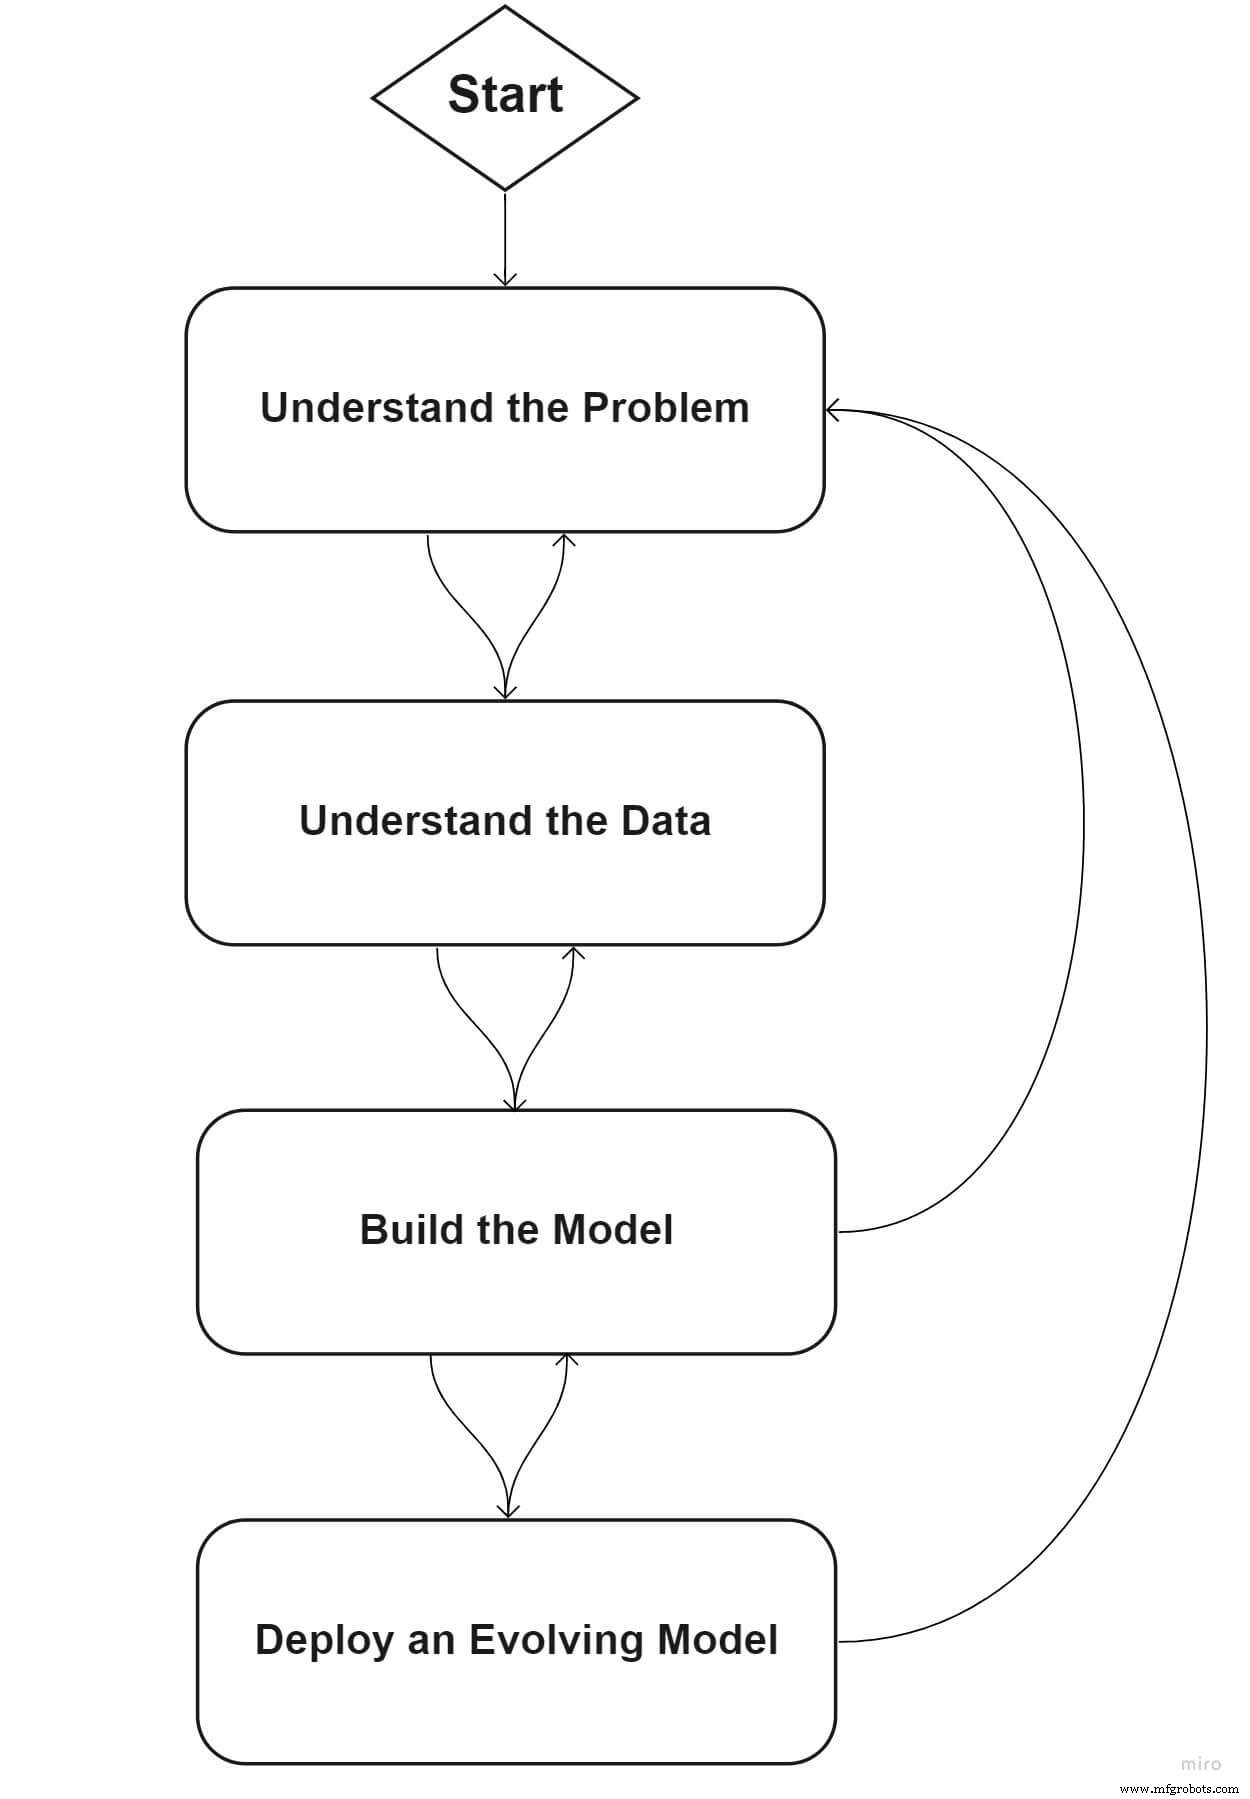
第一阶段:定义问题
任何ML计划核心有两问:
1. 您试图解决什么问题?
2. 为何相信ML与更好理解数据能帮解决手头问题?
答案取决于公司如何思考战略、评估业务问题。
第一阶段,关键利益相关者应聚首定义问题初始范围与需求。
第二阶段:理解数据
数据的故事是什么?数据从何来?多少数据源与解决特定业务问题相关?
此阶段企业聚焦:
梳理相关数据源及其所在环境(如本地部署或云、数据仓库、数据湖、流数据平台)
定义现有数据管道与需为数据验证、清洗、探索构建的管道
理解数据更新频次
理解数据可信度
评估数据隐私考量与要求
通过可视化、原始与转换数据统计属性等启用数据探索
理解数据非小任务。迭代法应对此阶段很重要。随发现更多数据信息,可能发现影响解决问题的议题,进而需从第一阶段重新定义或调整问题范围。
第三阶段:构建ML模型
数据就绪后,数据科学家构建ML模型。构建稳健ML模型常见步骤:
特征提取与工程(含分箱、数据白化、统计变换应用)
特征选择
模型训练(含将数据分割为任意数量的训练、交叉验证、验证数据集)
超参数调优
模型评估
统计显著性验证
模型开发需业务利益相关者持续反馈。例:业务问题可能要求敏感度对特异性的亲和力。可能为模型运营性能(如更快预测)或可解释性微牺牲预测性能(如F1分数)。
数据科学家目标是构建用数据讲清业务问题故事的模型。随问题演进需求变化,建模方法也必须演进服务当前语境。
第四阶段:部署进化模型
构建初始模型只是ML旅程开始。部署进化模型是组织长期价值创造的关键步骤。
部署进化模型要求:
服务模型(使模型高可用、水平可扩展)
管理模型版本(含回滚、金丝雀/挑战者部署)
重训练模型(随新数据进入系统修改或构建新模型)
监控模型(在服务与训练时跟踪运营与用户体验指标)
监控数据与模型漂移、为组织内针对性用例专业化模型、维护数据管道(及其他维护项)对模型持续成功至关重要。
企业级与行业级需求可快速演进影响数据源与输入。例:大规模治理合规是跨越数据科学全生命周期的考量。
合规法规——如欧盟(EU)通用数据保护条例(GDPR)——要求数据版本、模型版本、模型输入层面更深层可追溯。构建通过数据响应行业变化需求的策略助公司持续利用ML驱动更好业务成果:营收增长、成本降低、风险减少。
下一步?
以灵活、可维护、可扩展方式运营化ML需许多步骤与考量,超出本文高层范畴。魔鬼在细节。
下篇博客,我们将深入技术考量、大规模ML系统临时实施可能引发的挑战、UiPath如何助企业客户攻克常见难题。
自动化控制系统